AI 是放大器。放大能力,也放大無能。
同一套工具,資深工程師拿去把三天的重構壓縮成三小時,外行人拿去在三小時內做出一個看起來會動、但把資料庫憑證寫死在前端的系統。工具沒變,變的是使用者能不能看出產出有什麼問題。
這篇不是要唱衰 AI 開發。我們自己就是重度使用者——這個網站、公司內部 47 個專案裡有 30 個帶著 AI 開發規範檔。正因為用得深,才知道它在哪裡會出事。
先看數據:AI 生成的程式碼有基準缺陷率
這是整件事的起點,而且結論可能和你想的不同。
Veracode 2026 年 GenAI 程式碼安全報告的實測結果:
| 項目 | 通過率 |
|---|---|
| 整體平均 | 56% |
| SQL 注入防護 | 83% |
| 加密演算法選用 | 87% |
| 跨站腳本(XSS) | 15% |
| 日誌注入 | 12% |
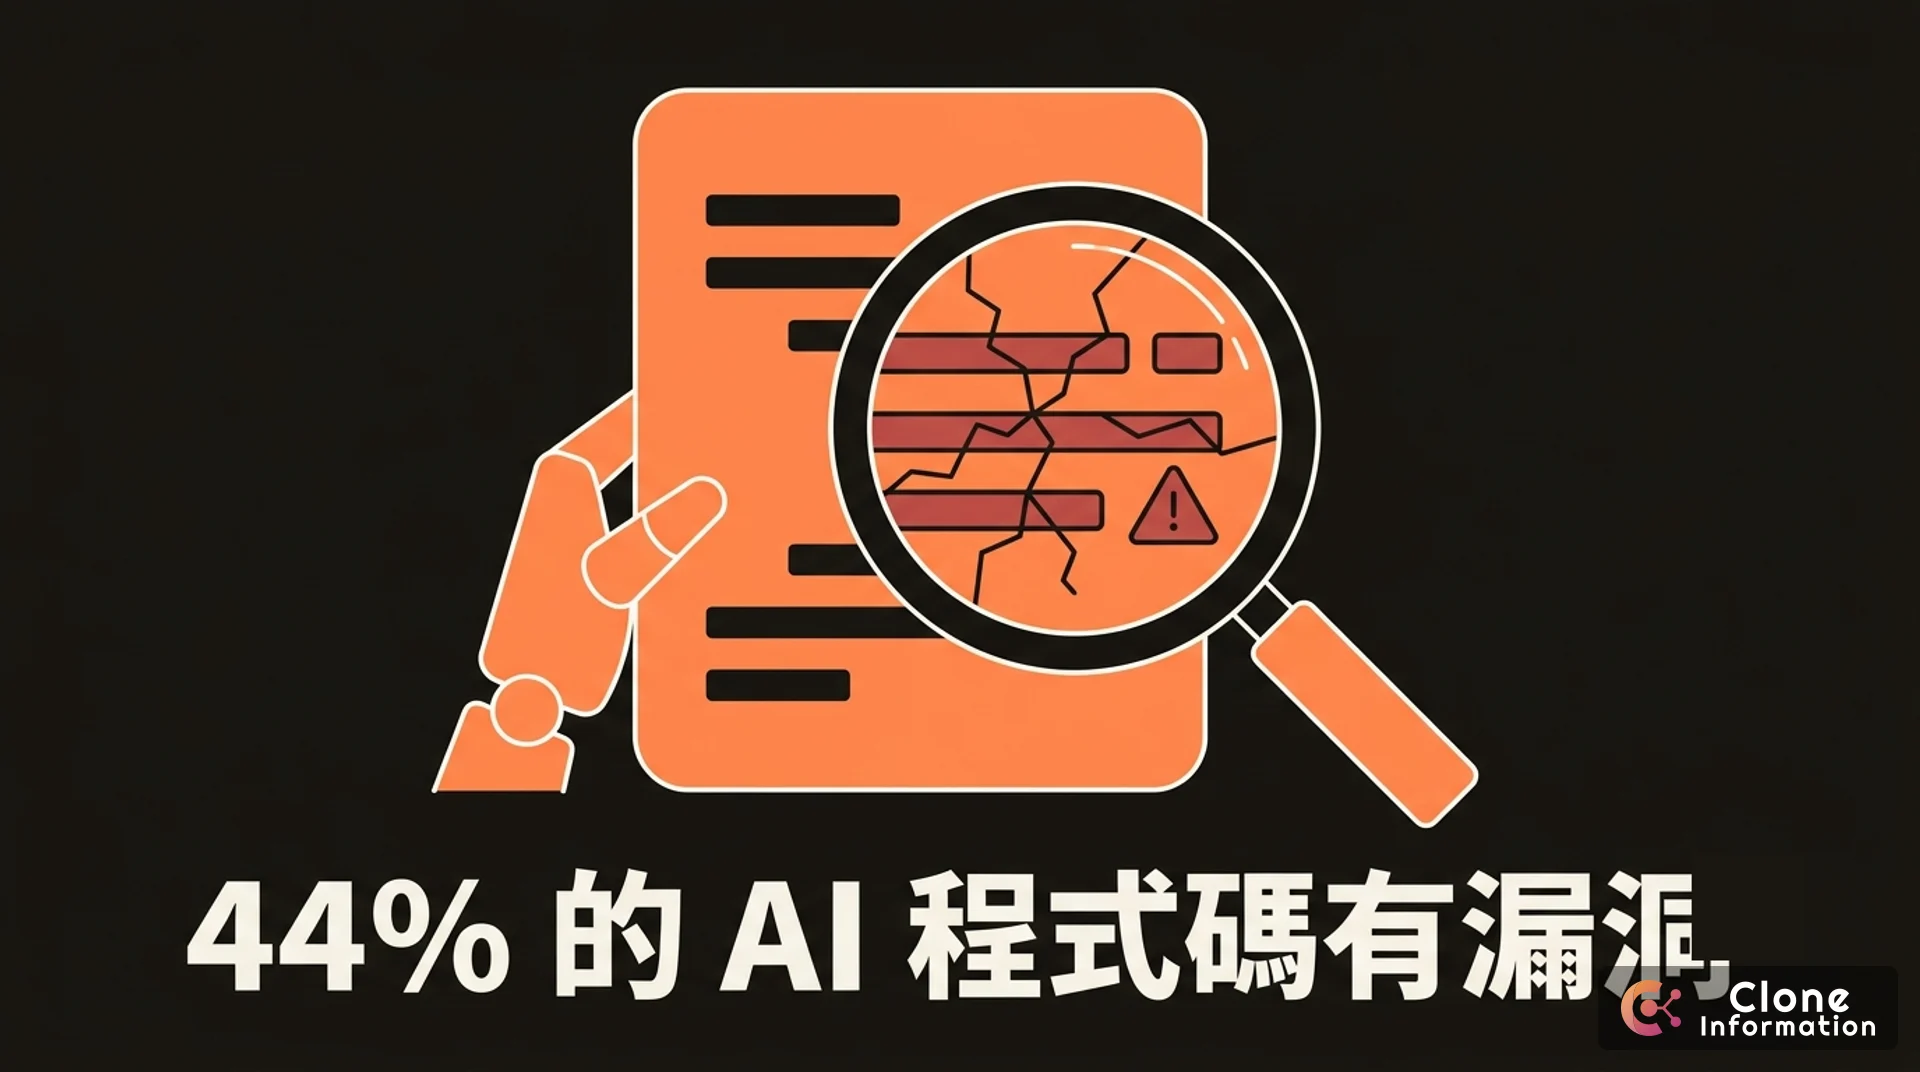
換句話說,約 44% 的 AI 程式碼生成任務會引入具風險的漏洞。而更值得注意的是:這個數字幾乎沒有進步——前一份報告是 55%,現在是 56%。模型能力大幅提升的同時,安全性原地踏步。
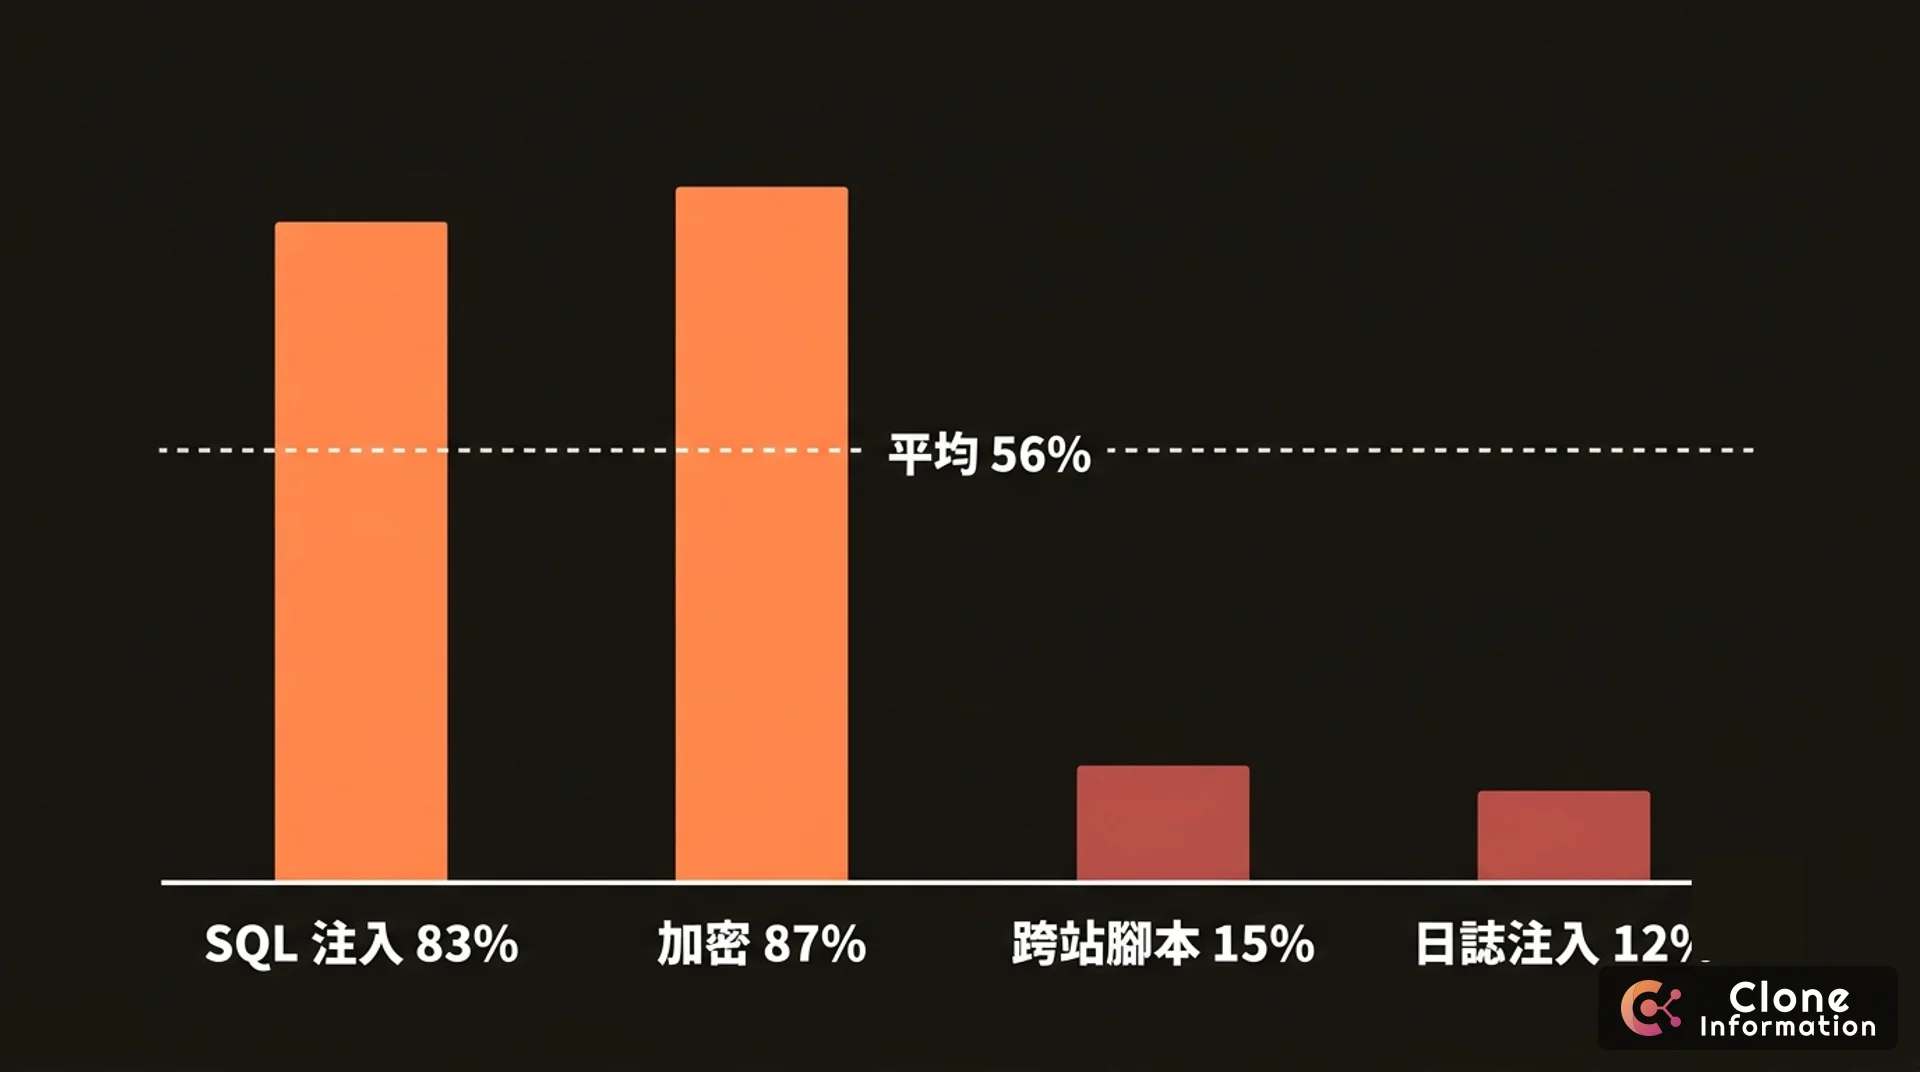
這裡有個關鍵:這些測試是研究人員在控制環境下做的,不是外行人亂下指令的結果。AI 產出的程式碼本身就帶著缺陷率,跟誰下 prompt 沒有關係。
所以問題不在「誰用」,在「誰驗收」
很多人把這件事講成「外行人用 AI 才危險」。這個說法不夠精確,而且會讓你錯過真正的重點。
資深工程師用 AI 一樣會生出有漏洞的程式碼。差別在於他看得出來。
他知道要問「這個 endpoint 有沒有檢查物件層級的權限」、知道 BOLA 長什麼樣、知道使用者可控的字串進到日誌會發生什麼事、知道為什麼那段看起來沒問題的 redirect 是 SSRF。
外行人不是「用錯 AI」,是根本不知道要檢查什麼。這不是態度問題,是知識儲備問題——你不可能檢查一個你沒聽過的漏洞類型。
能力差異不在產出端,在驗收端。這是整篇文章最重要的一句話。
已經在外洩了:三個真實案例
這不是假設性風險。
Lovable 平台事件(2026 年 4 月)——一個 BOLA(Broken Object Level Authorization,物件層級授權失效)漏洞,讓數千個專案的原始碼、憑證與 AI 對話紀錄暴露在外,持續 48 天才被處理。BOLA 是 OWASP API 安全風險排名第一的項目,也是 AI 生成程式碼最常漏掉的一類——因為它需要理解「這個使用者有沒有權限看這一筆」,而不只是「這段查詢語法對不對」。
RedAccess 大規模掃描(2026 年 5 月)——以色列資安公司掃描了約 38 萬個建置在 vibe-coding 平台(Lovable、Base44、Replit、Netlify)上的應用,發現其中約 5,000 個正在洩漏企業或個人敏感資料。
Moltbook 資料外洩——一個完全由 AI 生成的應用,因資料庫設定錯誤,外洩 150 萬組 API token 與 3.5 萬筆電子郵件。
雲端安全聯盟(CSA)的研究則指出,到 2025 年 6 月,AI 生成的程式碼每月在受研究的儲存庫中新增超過 10,000 項資安發現,是 2024 年 12 月的十倍。
這些都不是「寫得比較差」而已。資料庫設定錯誤、憑證外洩、缺少授權檢查——三種最常見的失效模式,共通點是:如果你不知道要檢查,它們不會自己跳出來。
一個反直覺的數據:連資深的人都會高估 AI
這是我認為最值得所有人看的一份研究。
METR 於 2025 年 7 月發表的隨機對照試驗——注意,是 RCT,藥物試驗等級的方法論——找了 16 位資深開源開發者,在他們自己維護的專案上執行 246 個真實任務。這些專案平均超過 100 萬行程式碼、約 10 年歷史。
結果:
- 使用 AI 工具的組別,完成時間慢了 19%
- 但受試者自己認為快了 20%
- 開發者實際採用的 AI 生成內容不到 44%
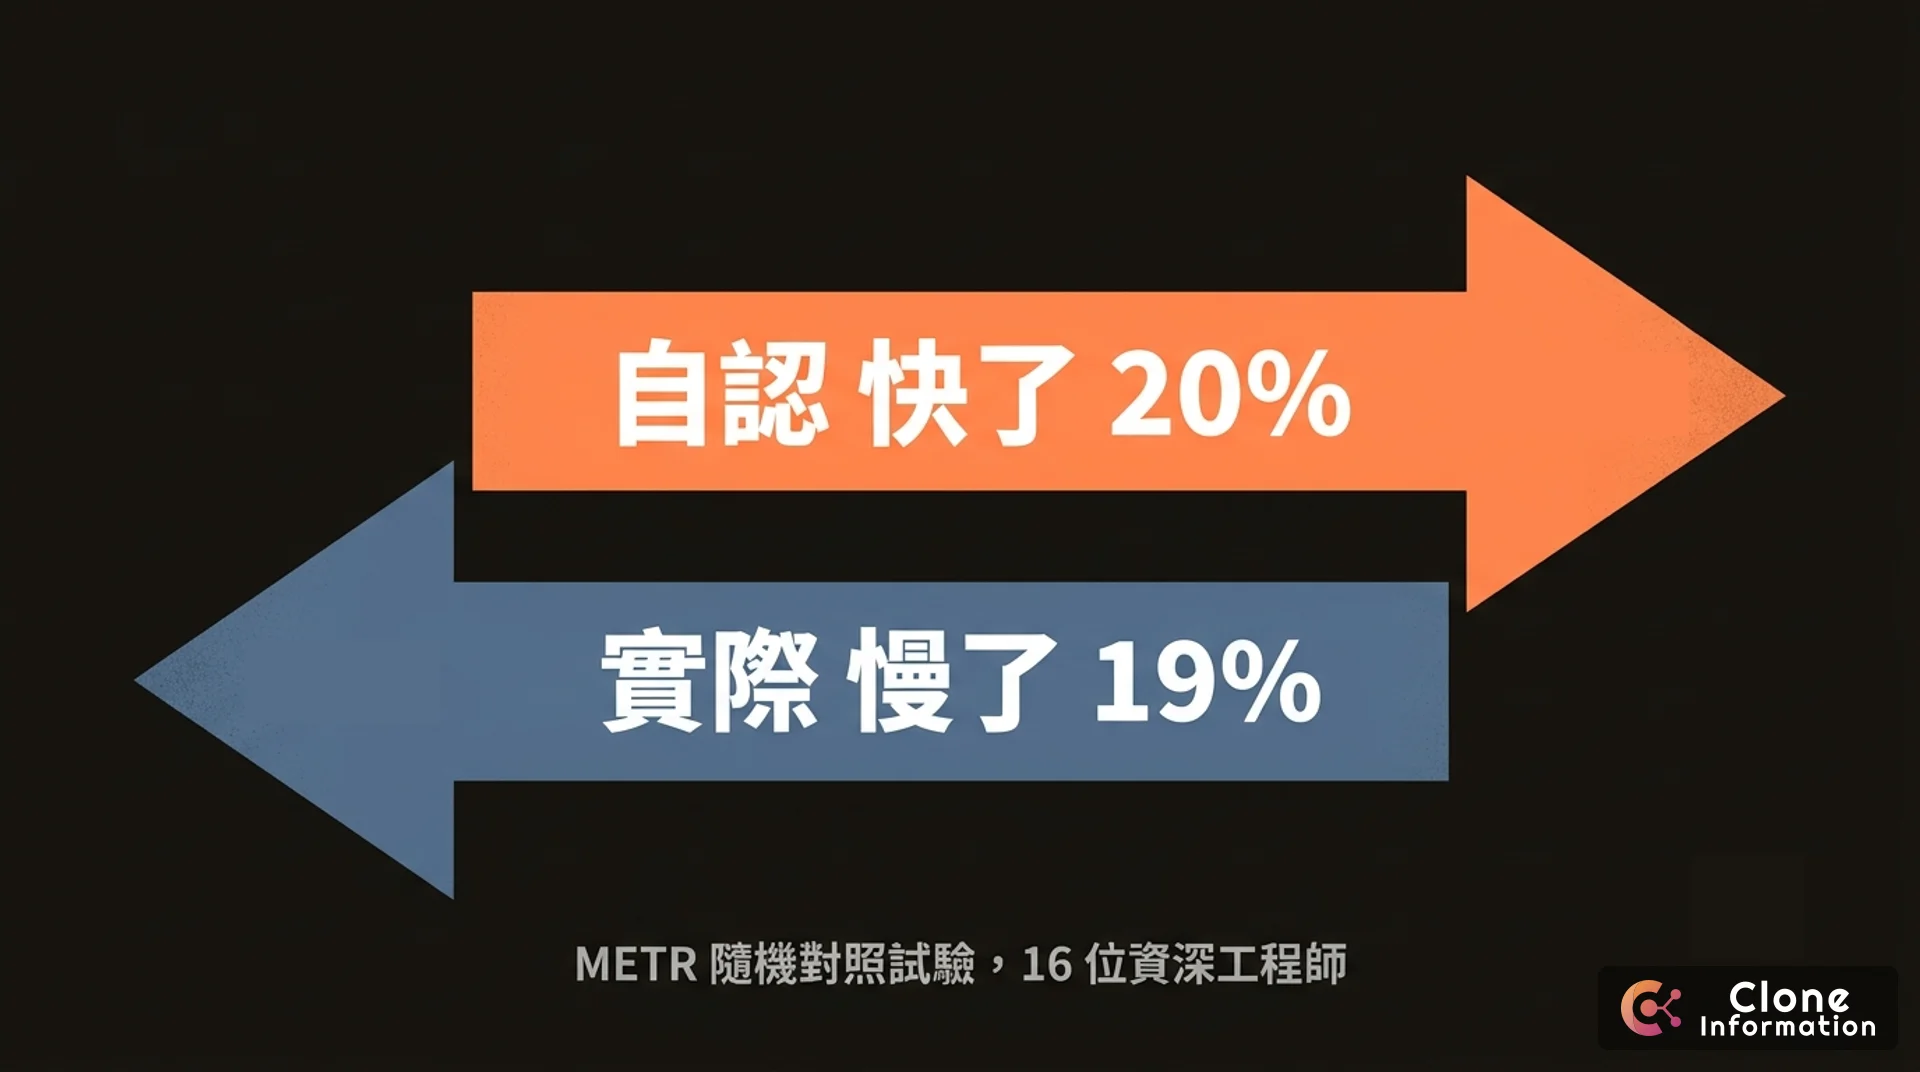
落差 39 個百分點。 而這是資深工程師在自己最熟悉的專案上的自我評估。
原因不難理解:AI 在大型成熟的程式庫上表現較差,而審閱、測試、修改一段最後決定不用的生成程式碼,那些時間並不會消失。研究者稱之為「額外的認知負荷與情境切換」。
如果連資深的人都會把自己的效率高估這麼多,外行人對「我做出來的系統有多完整」的自我評估,會偏離到什麼程度?
自己用可以,賣給客戶是完全不同的一件事
這是整件事的分水嶺,也是我最想講的部分。
用 AI 做自己的工具,非常合理。 排程腳本、資料整理、內部小工具——壞了你自己承擔,資料是你自己的,沒有第三方受害。這種情境下 AI 的投報率極高,我們自己也天天在做——我們也寫過如何用免費工具打造 LINE Bot AI 助理這類自用型專案的實作。
但把它當成「系統開發很容易」而拿去收錢,是另一回事。
差別不在技術,在責任:
| 自己用 | 賣給客戶 | |
|---|---|---|
| 壞掉的代價 | 自己重做 | 契約責任、賠償 |
| 資料外洩 | 自己的資料 | 客戶的客戶資料、個資法 |
| 三年後要改 | 自己想辦法 | 客戶找不到人維護 |
| 出事時 | 自己知道哪裡怪 | 你要說得清楚 |
判斷標準其實很簡單:這套系統一旦外洩資料,你能不能說清楚是哪一層出的問題、影響範圍多大、怎麼修?
答不出來就不該收錢。這不是道德勸說,是風險自保——台灣《個人資料保護法》對非公務機關的資料外洩有行政罰與民事賠償責任,而「系統是 AI 寫的」不會是免責事由。
可交付、可維護、可交接:三道檢查點
一個能收錢的專案,至少要過這三關。這也是我們自己的驗收標準。
可交付
- 能不能說出這套系統的信任邊界在哪裡?哪些輸入是不可信的?
- 權限檢查在哪一層做?如果前端被繞過,後端擋不擋得住?
- 密鑰、token、連線字串在哪裡?有沒有進版控?
- 如果資料庫直接被連上,看得到什麼?
可維護
- 三個月後你自己看得懂嗎?六個月後呢?
- 改一個功能,會不會弄壞另外三個?有沒有測試能告訴你?
- 依賴套件有沒有版本鎖定?升級會不會炸?
可交接
- 客戶換一家廠商,對方三天內接得手嗎?
- 有沒有文件說明為什麼這樣設計,而不只是怎麼運作?
- 部署流程是不是只存在某個人的腦袋裡?
這三關都跟「AI 能不能寫出這段程式」無關,跟「你知不知道要問這些問題」有關。
想把 AI 真正導入企業流程而不是拿來寫一次性腳本,可參考我們的AI Agent 企業應用實戰部署指南,裡面談的正是治理、權限與落地的順序問題。
人才市場:分裂,而不是齊漲
很多人把「AI 取代工程師」講成一個單一趨勢,實際數據顯示的是市場在分裂。
初階在萎縮:
- 初階開發職缺過去一年全球下滑約 20% 至 35%
- 15 家最大科技公司的初階招聘自 2023 到 2024 年下降 25%
- 22 至 25 歲開發者的就業數自 2022 年底下滑近 20%
資深與專精在上升:
- ML/AI、資安、資料、平台架構等角色需求強勁
- 深度專業(ML、DevOps、雲端架構、資安)薪資溢價達 20% 至 40%
- 企業裁掉的是 AI 能取代產出的角色(基礎 CRUD 開發、手動測試、套版設計),加碼的是 AI 需要人來指導的角色(系統架構、AI 工程、產出審閱)
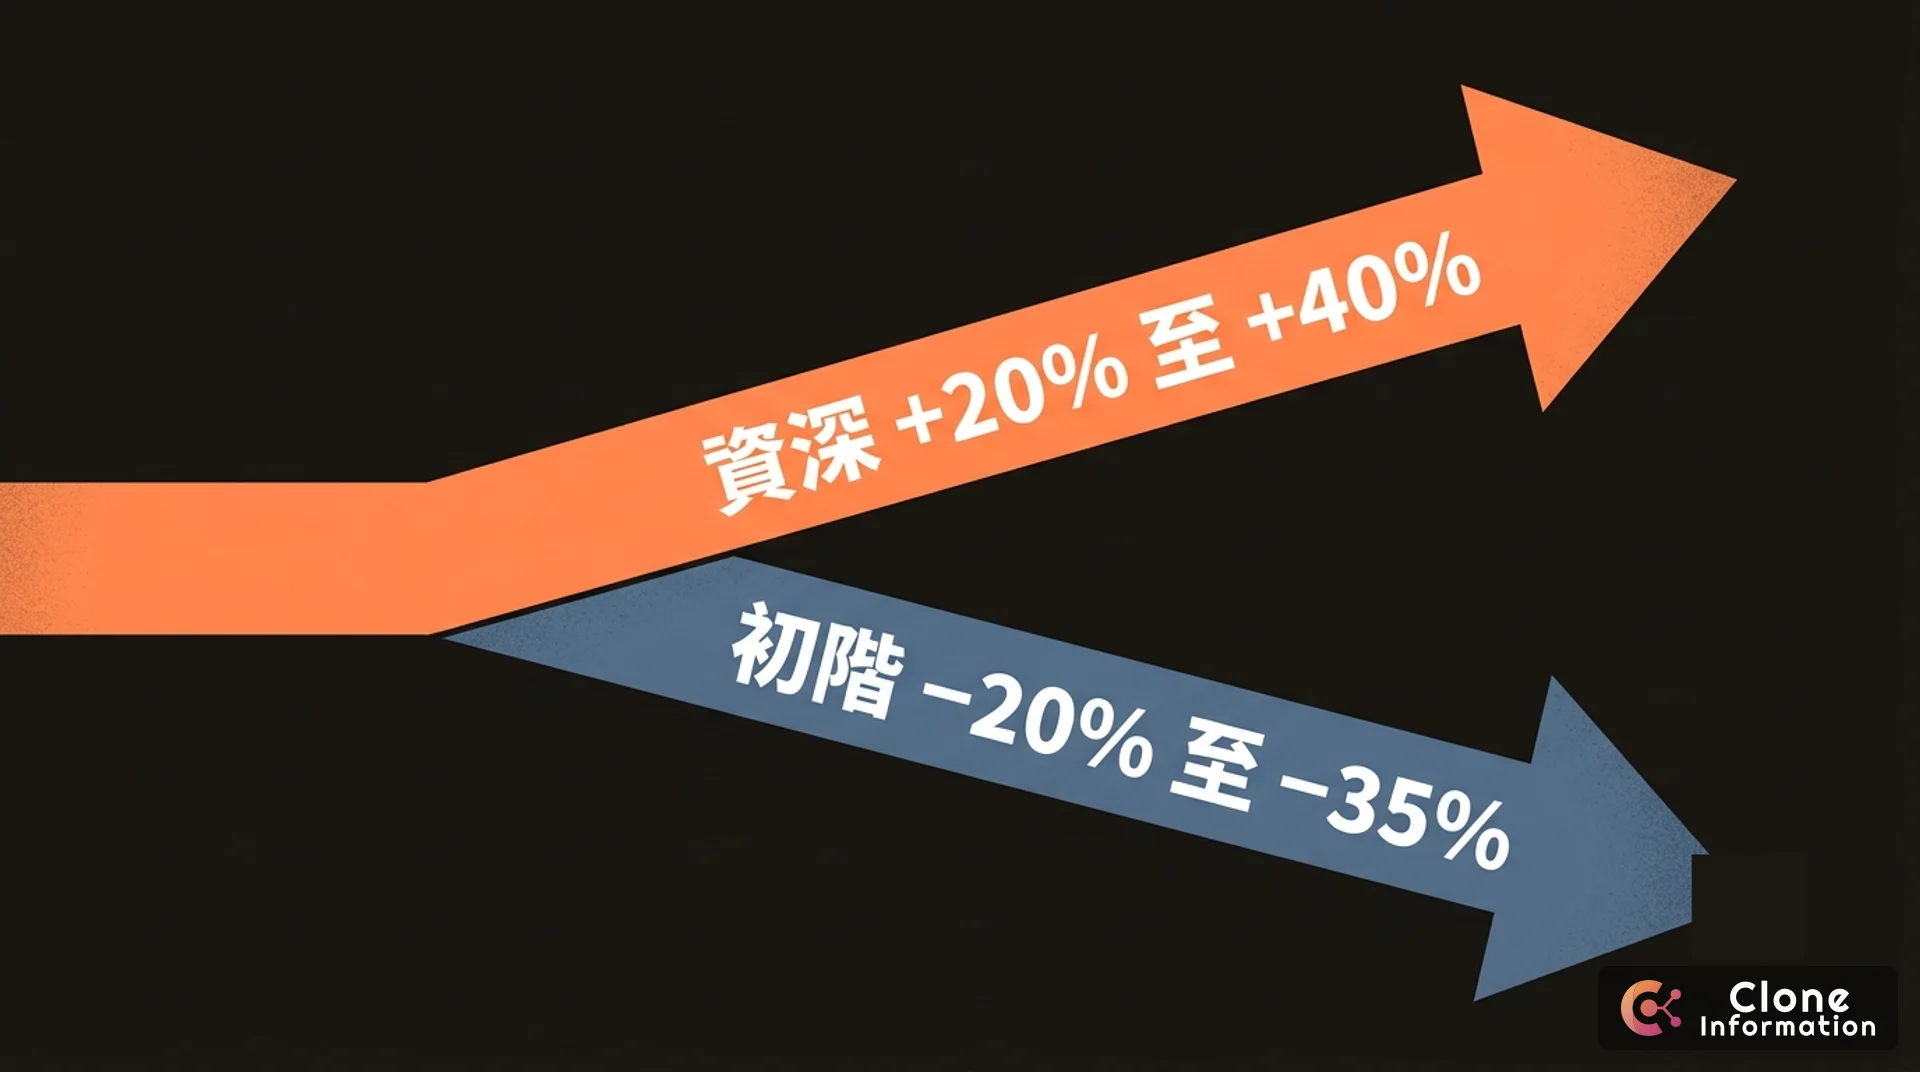
但要講精確:整體職缺數雖有回升,仍低於 2021 年高點。 說「資深職缺大幅成長」會失真,正確的說法是——相對於初階,資深的議價能力明顯提升。
這個趨勢的內在邏輯其實就是前面所有數據的結論:當產出變得廉價,驗收能力就變成稀缺資源。
AI 讓「寫出程式碼」這件事的門檻大幅降低,但「判斷這段程式碼能不能上線」的門檻一點都沒降。後者需要的是架構經驗、資安知識、對失效模式的直覺——這些東西目前無法用三個月的課程補起來,而需求正在上升。
資深架構師與資深全端工程師的價值,不在於他們打字比較快,而在於他們知道什麼時候該說「這樣不行」。
我們的立場
我們用 AI,而且用得很深。它讓我們能以極小的團隊交付過去需要三五個人的專案。
但我們也很清楚:AI 給我們的是產出速度,不是判斷力。 判斷力來自那些踩過的坑、修過的資安事件、接手過別人爛攤子的經驗。
如果你正在評估要不要把系統開發交給某個人或某家公司,有一個問題比「你們用什麼技術」更值得問:
「如果這套系統上線後外洩了客戶資料,你們會怎麼處理?」
答得出流程的,代表想過這件事。答「我們會很小心」的,代表沒有。
如果你正在評估系統開發需求,歡迎先看看我們的客製化系統開發服務,或直接與我們談談你的專案——先談問題,不急著談系統。
本文引用資料來源:Veracode 2026 GenAI Code Security Report、Cloud Security Alliance:AI-Generated Code Vulnerability Surge、METR: Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity、OWASP API Security Top 10:Broken Object Level Authorization、The Pragmatic Engineer: State of the software engineering job market in 2026。