批發零售通路
在 ChatGPT 直接查 ERP
ERP AI 整合的前提:AI 不會組 SQL、碰不到主庫,每一次查詢都留稽核
以唯讀 MCP Server 做 ERP AI 整合,員工在 ChatGPT 就能查非敏感資料。AI 不組 SQL、主庫零接觸,另附白名單、權限、用量與稽核後台,開放範圍由伺服器決定。
AI 沒有能力做壞事
它只能呼叫預先寫死的查詢工具,選工具、填參數,沒有組合出意外查詢的空間。不是事後檢查 SQL 安不安全。
主庫全程零接觸
唯讀 VIEW 讀唯讀副庫。即使前面每一層都被突破,能碰到的仍只是一個受限視圖。
管得住才敢開放
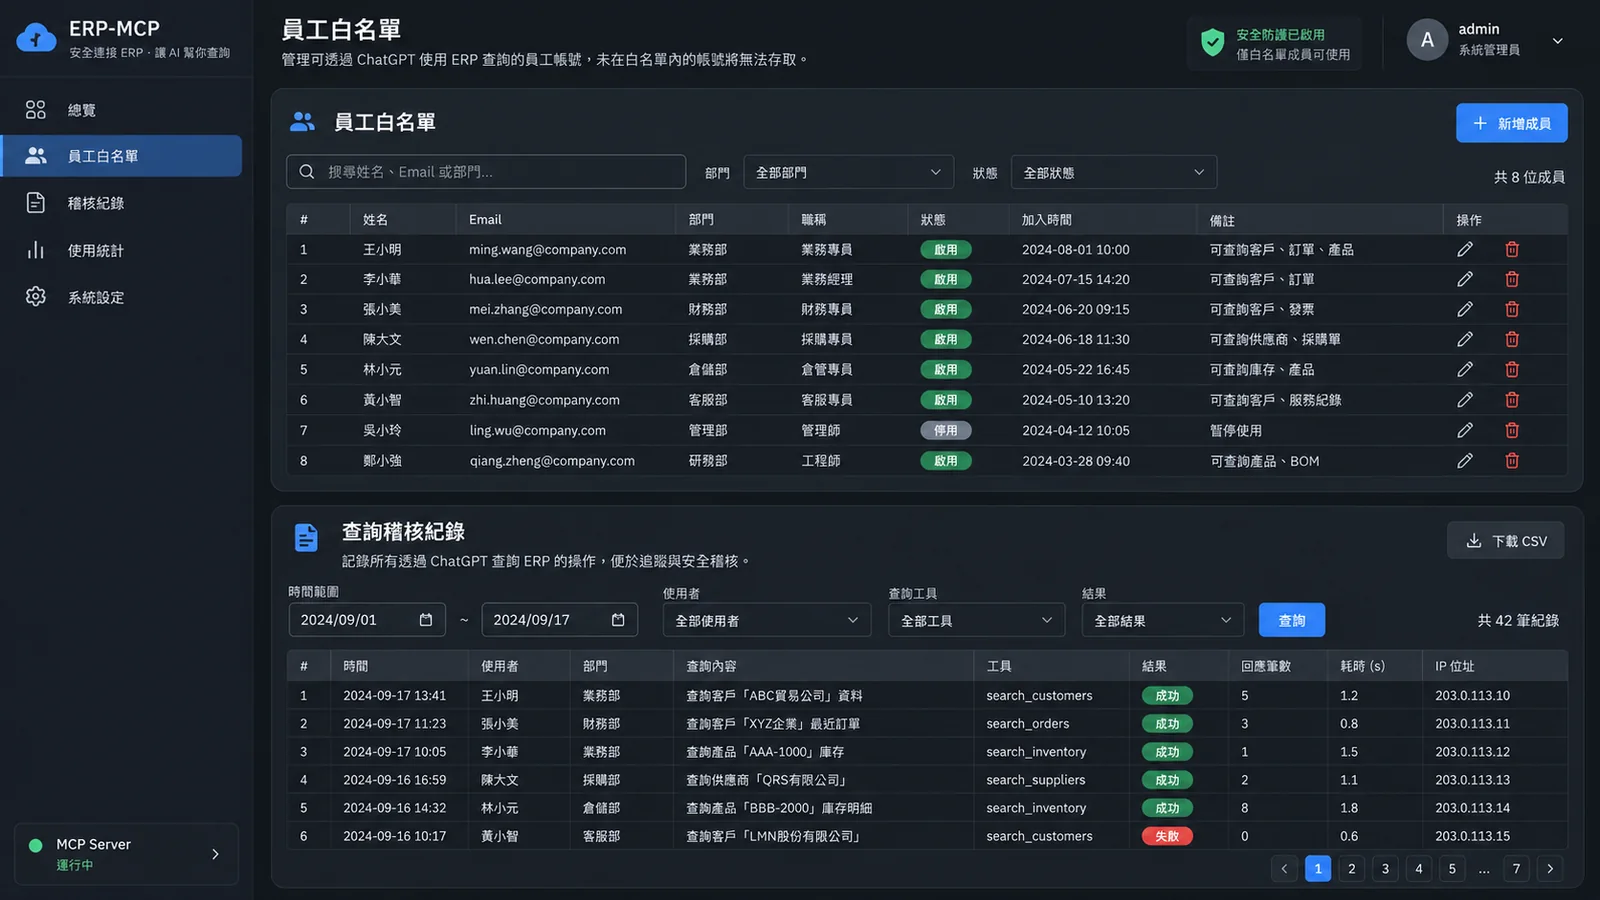
白名單決定誰能用、權限決定看得到什麼、稽核保留每一次查詢的內容與時間。出事查得到。
怎麼運作
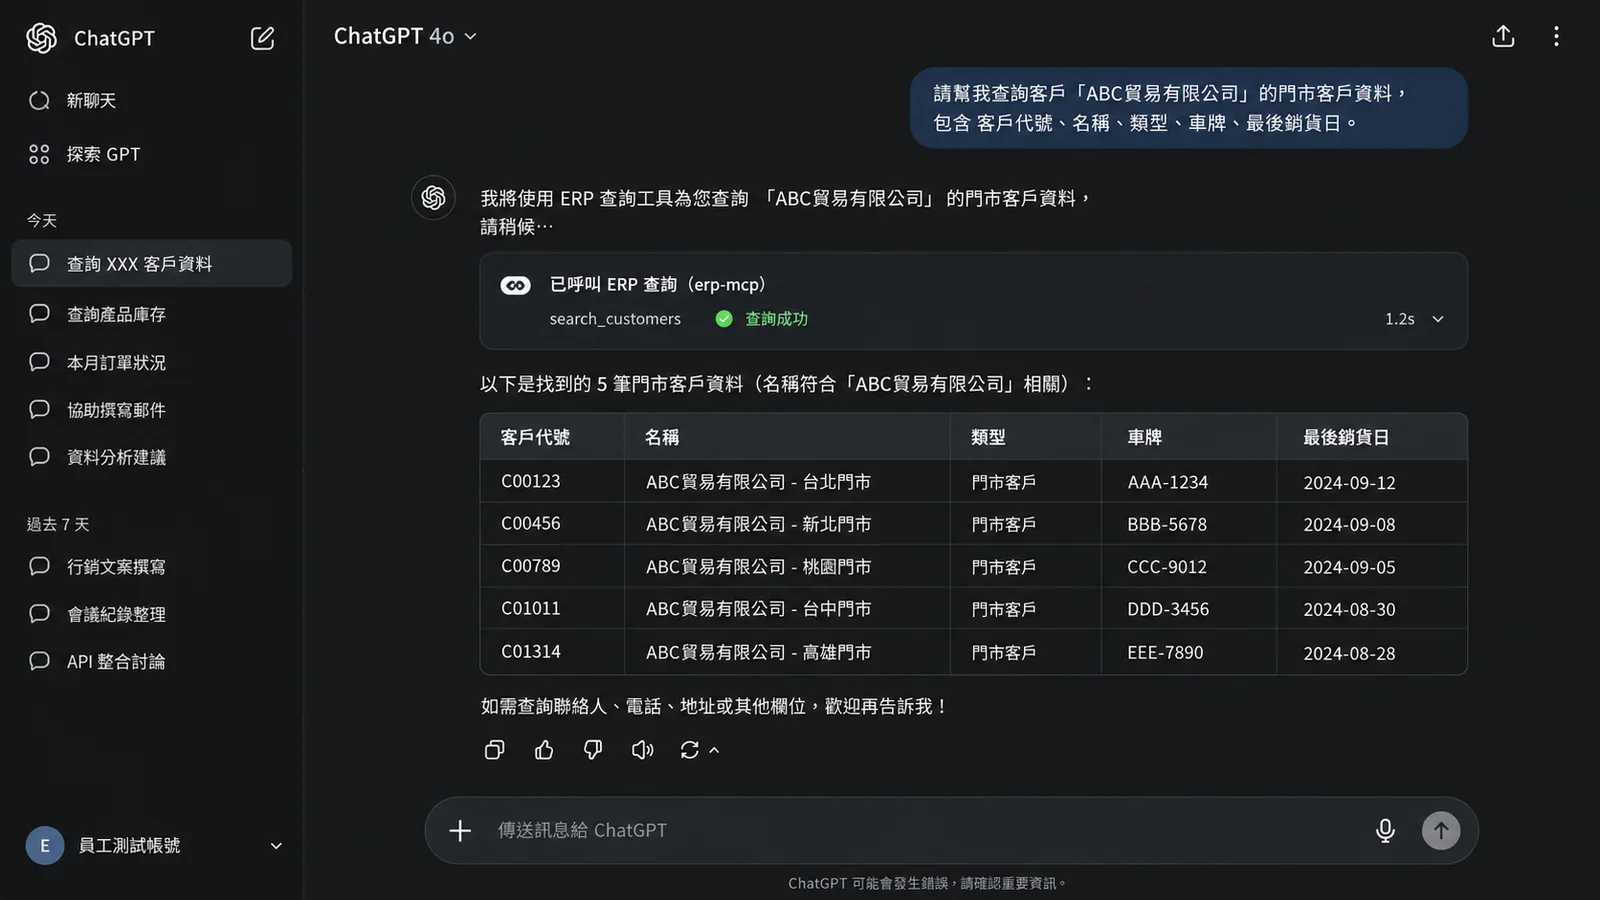
員工在 ChatGPT 發問
用日常語言詢問庫存、出貨或客戶資料,不必記得任何系統操作。
伺服器選定查詢工具
MCP Server 依問題挑選預先定義的工具,資料範圍與可回傳欄位都在伺服器端寫死。
唯讀取得並留下紀錄
經受限視圖取得資料回覆,同時寫入稽核紀錄。
規格
- AI 組 SQL
- 不允許
- 主庫接觸
- 零
- 資料權限
- 唯讀 VIEW
- 身分驗證
- 服務令牌
- 查詢稽核
- 全程記錄
- 存取控管
- 白名單
問題:想用 AI 查資料,但沒人敢把 ERP 接上去
「能不能讓員工直接問 AI 現在還有多少庫存?」這個需求每家公司都提過,然後都卡在同一個地方——把 ERP 接給 AI,等於把整間公司的帳交出去。企業 AI 導入卡住的通常不是模型好不好用,是資料安全這一關沒有人敢簽。
擔心的具體是三件事:AI 會不會下出破壞性的 SQL、會不會查到不該看的薪資與成本、出事之後查不查得出是誰在什麼時候問了什麼。ERP AI 整合要先解掉這三題,才輪得到談好不好用。
解法:讓 AI 沒有能力做壞事,而不是要求它別做
多數方案的做法是「讓 AI 生成 SQL,再檢查生成的 SQL 安不安全」。這個方向從根本上是脆弱的:檢查邏輯永遠在追新的繞過手法。
本系統改用相反的前提——AI 完全不接觸 SQL。它只能呼叫預先定義好的查詢工具,每個工具的資料範圍、可回傳欄位與參數型別都在伺服器端寫死。AI 能做的只有「選一個工具、填參數」,沒有任何組合出意外查詢的空間。
資料路徑同樣層層收斂:
- Cloudflare Worker 經 Hyperdrive 連線,不暴露資料庫位址
- 以 Cloudflare Access 服務令牌驗證身分,經 Tunnel 進入內網
- 只能存取 Supabase Postgres 中的
erp_mcpVIEW(唯讀) - 該 VIEW 再以
postgres_fdw讀 ERP 的唯讀副庫(standby)
也就是說,即使前面每一層都被突破,最終能碰到的仍只是一個唯讀副本上的受限視圖。ERP 主庫全程零接觸。
繼續看:架構、工程紀律與據實說明
管得住,才敢開放
附帶的管理後台處理的是「誰能用」而不只是「怎麼用」:白名單控管可存取的人員、權限決定各自看得到哪些工具、用量統計避免異常呼叫、稽核紀錄保留每一次查詢的內容與時間。
沒有稽核就不該開放——不是因為不信任員工,而是出事時需要有紀錄可查,這對開放方與使用方都是保護。這也是 ChatGPT 企業應用與個人使用最大的差別:個人只要答得準,企業還要答得出「誰問的、什麼時候問的、看到了哪些欄位」。
目前狀態
此專案為近期啟動,架構已完成、功能實作進行中,尚未進入長期營運階段。此處據實說明,不宣稱為成熟產品。若您的公司正在評估類似需求,這套架構的設計取捨可直接參考。
關於這個案子,常被問到的是
把 ERP 接給 AI,會不會被下指令刪資料?
這套架構下 AI 沒有能力做這件事,不是靠規則攔。AI 完全不接觸 SQL,只能呼叫預先定義好的查詢工具,每個工具的資料範圍、可回傳欄位與參數型別都在伺服器端寫死,它能做的只有選一個工具、填參數。
員工會不會查到薪資、成本這類不該看的資料?
看不到。資料來源是 Postgres 裡的唯讀 VIEW,該 VIEW 再以 postgres_fdw 讀 ERP 的唯讀副庫,欄位範圍在建立 VIEW 時就決定了。另外後台有白名單與權限分層,決定誰能用、各自看得到哪些工具。
MCP Server 是什麼?跟直接接 API 差在哪?
MCP 是讓 AI 客戶端呼叫外部工具的協定。差別在主導權:接 API 通常是 AI 自己組查詢,MCP 則是由伺服器公告「有哪些工具、各自吃什麼參數」,AI 只能在這份清單裡選。要限制 AI 的能力範圍,後者容易得多。
企業 AI 導入要先準備什麼?
先決定開放範圍,再談技術。實務上第一步是列出「哪些欄位可以被查」,這一步是業務決策不是工程決策;確定之後才有辦法把它寫成唯讀 VIEW 與工具定義。另外要先接受一件事:沒有稽核紀錄就不該開放。