llms.txt 是 Jeremy Howard 在 2024 年 9 月 3 日提出的提案:在網站根目錄放一份 Markdown 檔,用簡短說明加連結清單,讓大型語言模型需要時讀到網站重點。先講現況:它不是正式標準,Google 寫明搜尋不使用它,OpenAI 與 Perplexity 的爬蟲說明也沒寫會讀它。成本很低,可以做,但別期待它影響排名或引用。
為什麼會有 llms.txt?
提案的理由寫在規格開頭:網頁是做給人看的,內容包在導覽列、廣告與 JavaScript 裡,「converting it back into clean text is difficult and imprecise」;而 AI 的上下文長度雖然變大了,仍「too small for most websites in their entirety」。所以提案用一份精簡的 Markdown 索引,讓 AI 代理需要時一次讀到重點。
這個用途寫得很清楚:它是給 AI 讀的索引,不是給搜尋引擎的收錄規則,也不能用來擋爬蟲。
llms.txt 格式怎麼寫?
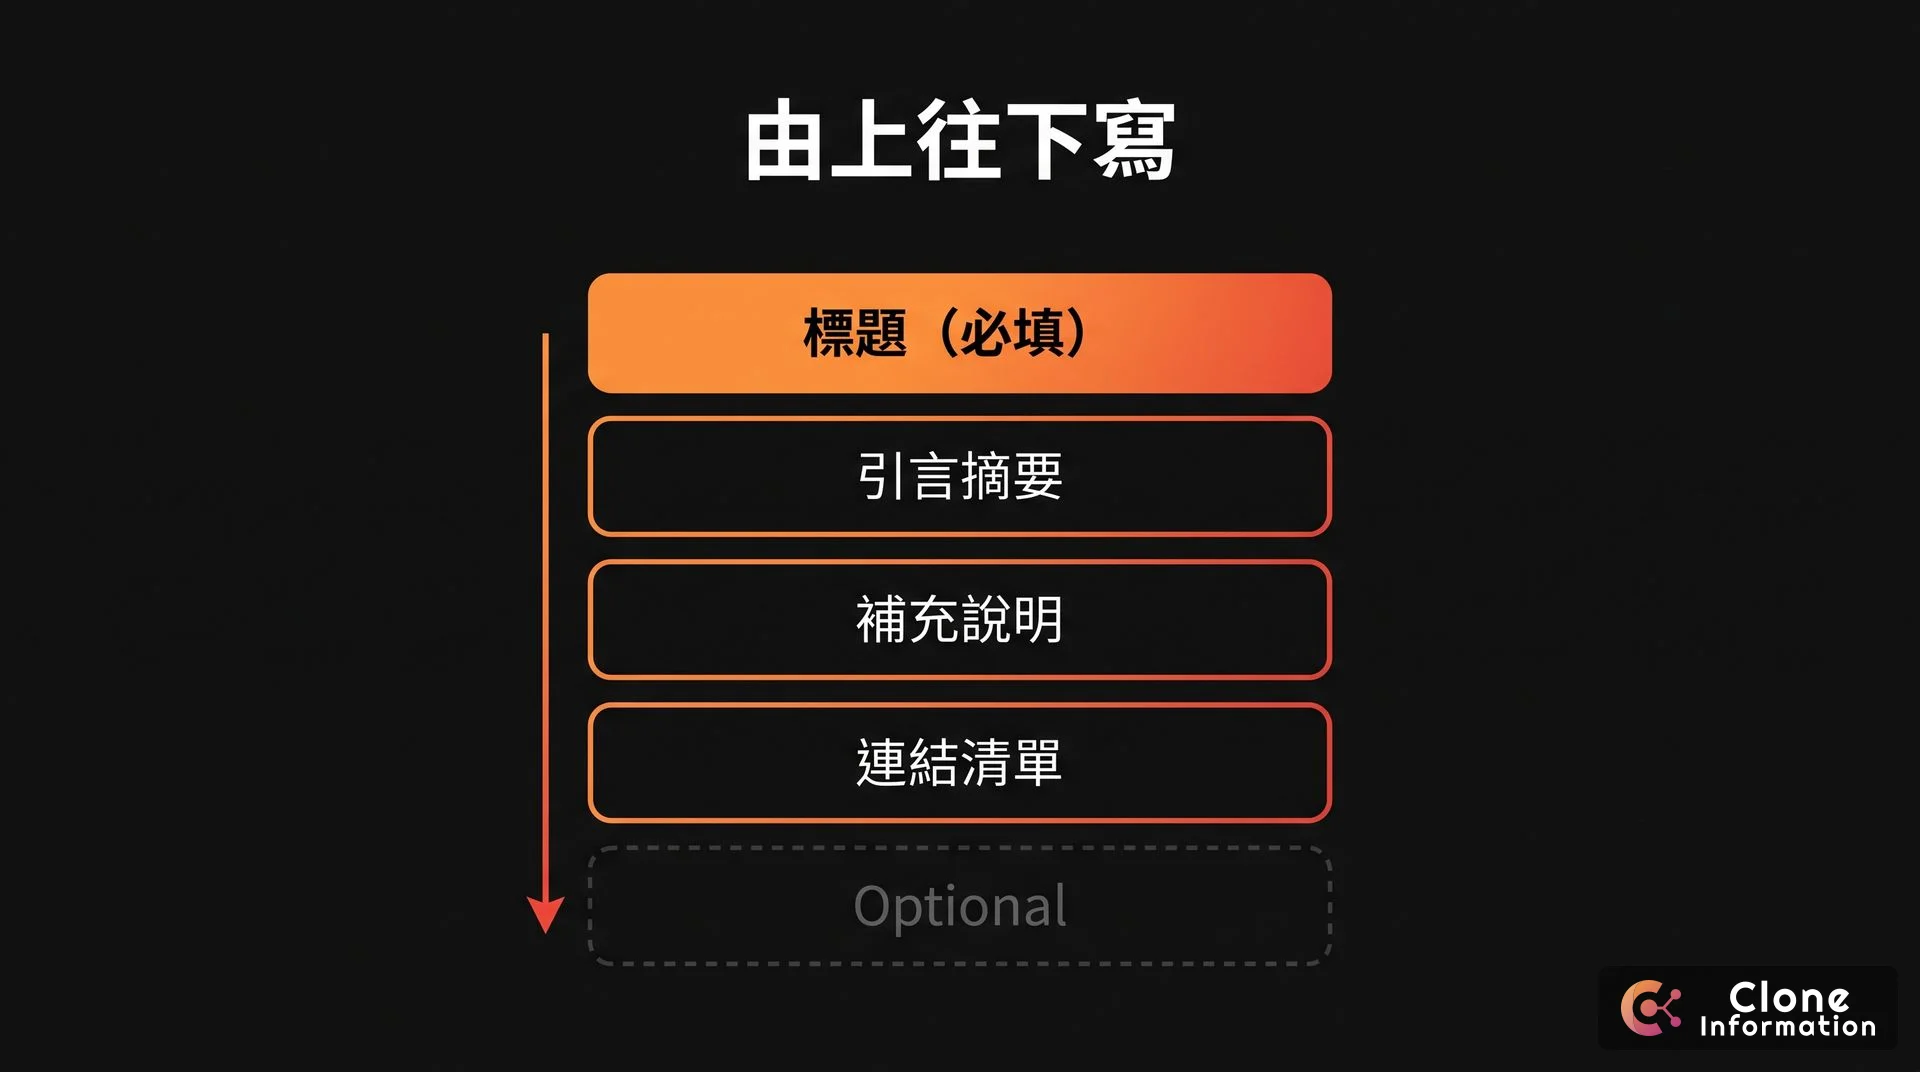
規格只規定順序,唯一必填的是第一行的 H1:
- H1:網站或專案名稱(唯一必填)
- 引言:用 Markdown 引言寫一段簡短摘要
- 補充說明:零到多段文字,不能用標題
- 檔案清單:用 H2 分段,每項寫成
[名稱](網址): 說明,冒號後的說明可省略 - Optional:慣例上用名為 Optional 的 H2 段落放次要內容,AI 內容放不下時可以略過
照規格寫的最小範例:
# 克隆資訊有限公司

> 高雄的軟體開發公司,提供企業系統開發、AI 工作流與 SEO 等服務。

## 服務項目

- [技術 SEO 健檢](https://clone-info.net/seo-services/): 索引、轉址、結構化資料與 AI 搜尋能見度

## 技術文章

- [GEO 優化是什麼?](https://clone-info.net/blog/geo-optimization-guide/): 論文、Google 與 OpenAI 官方怎麼說

## Optional

- [隱私權政策](https://clone-info.net/privacy-policy/)
規格還建議為重要頁面提供 Markdown 版本,網址與原頁相同,在後面加 .md 或把副檔名換成 .md;沒有檔名的網址用 index.html.md 或 index.md。網路上流傳的 Title:、Keywords: 欄位或排除路徑語法,都不在規格裡。
放在哪裡、怎麼確認寫對?
檔案放在網站根目錄的 /llms.txt;規格也允許放在子路徑,例如 /docs/llms.txt,涵蓋那個路徑底下的頁面。放好之後用瀏覽器直接打開,確認看得到純文字、清單裡的連結都能公開瀏覽,不要放需要登入的頁面。檔案用 UTF-8 存檔,中文才不會變成亂碼;多語系網站可以在各語系路徑下各放一份,例如 /en/llms.txt。
有些文件站會另外放 llms-full.txt,把全文串成一份,例如 Anthropic 的開發者文件。這不在規格裡,一般公司官網不需要。內容常更新的網站,建議用程式依頁面清單自動產生,避免連到已經下架的頁面。
llms.txt 和 robots.txt 差在哪?
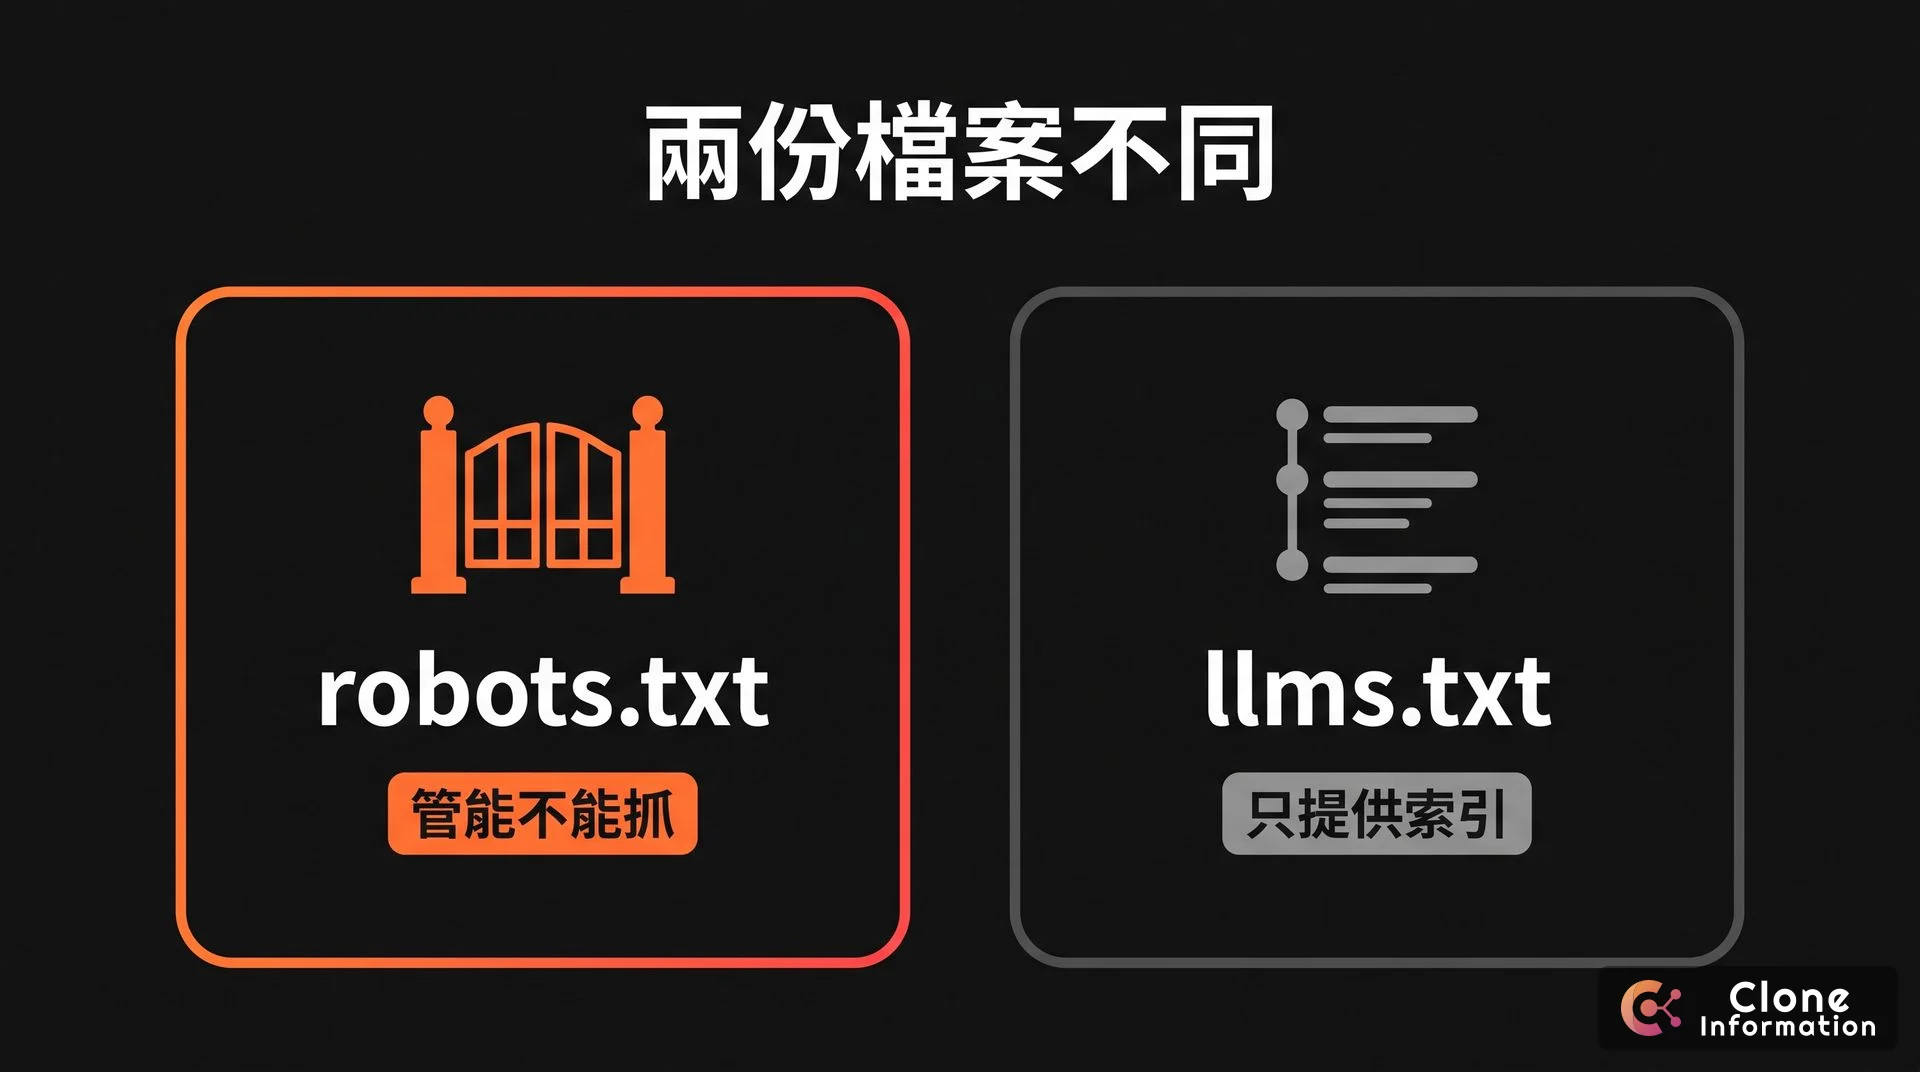
兩者都放在網站根目錄,用途卻完全不同。規格原文說得清楚:robots.txt「lets automated tools know what access to a site is considered acceptable」,llms.txt 則是「used on demand, when an agent needs information」。
| 項目 | robots.txt | llms.txt |
|---|---|---|
| 用途 | 告訴爬蟲哪些路徑可以抓 | AI 需要時讀的重點與連結 |
| 地位 | RFC 9309 正式標準 | 社群提案 |
| 能不能擋爬蟲 | 能(由爬蟲遵守) | 不能,沒有封鎖語法 |
| 格式 | User-agent 與 Allow、Disallow 規則 | Markdown |
| Google 搜尋 | 會讀 | 不使用 |
兩份檔案可以同時存在、互不影響,但它不能取代 robots.txt。想擋 AI 爬蟲、或只放行搜尋用的爬蟲,要寫在 robots.txt,做法見〈GEO 優化是什麼?〉。
Google、OpenAI、Perplexity 怎麼看 llms.txt?
| 公司 | 官方怎麼說 |
|---|---|
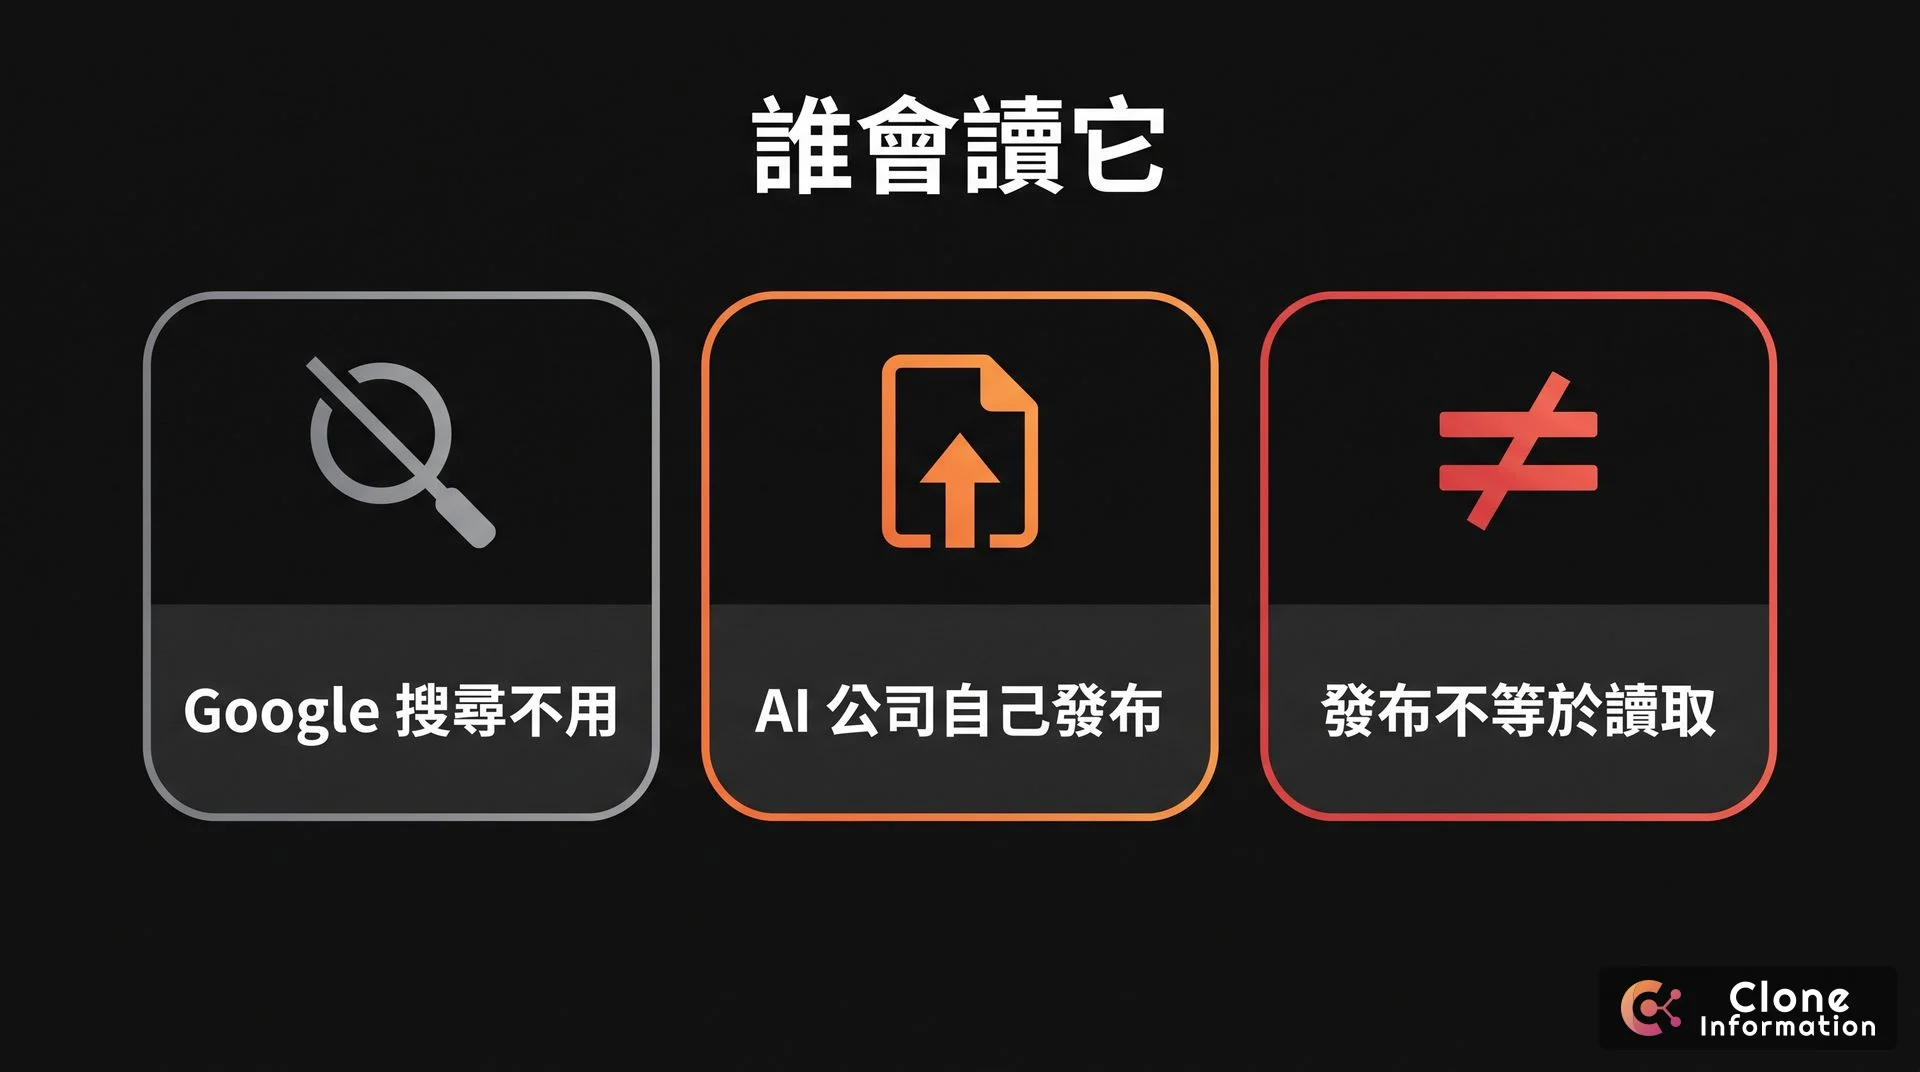
| 「Doing so will neither harm nor help your site’s visibility or rankings in Google Search, as Google Search ignores them.」 | |
| OpenAI | 爬蟲說明頁沒有寫爬蟲會讀取網站的 llms.txt |
| Perplexity | 爬蟲說明頁沒有寫爬蟲會讀取網站的 llms.txt |
這句話的意思是:Google 搜尋,包含 AI 摘要與 AI 模式,都不使用這份檔案。網站要出現在 Google 的 AI 功能,條件和一般搜尋一樣:頁面要被編入索引、能在搜尋結果顯示摘要,Search Console 的「搜尋生成式 AI」設定也要維持納入。
容易混淆的是:OpenAI、Anthropic、Google 的 Gemini 都在自己的開發者文件放了這份檔案,OpenAI 與 Perplexity 的爬蟲說明頁甚至附上自家文件的 llms.txt 連結。但那是它們「發布」給開發者用,不代表它們的爬蟲會讀你網站上的。另一個容易混淆的是 Chrome 的 Lighthouse:llmstxt.org 寫明它會在 agentic browsing 檢查裡稽核這份檔案,但那是瀏覽器工具的檢查項目,和 Google 搜尋用不用它是兩回事。
本站的存取紀錄也是這樣。我們查了本站 2026 年 9 月 9 日到 10 月 2 日的 Cloudflare 存取紀錄:讀它的是 SEO 與 GEO 分析工具的爬蟲,以及瀏覽器與 curl 等工具;同一段期間,來自 OpenAI 公布 IP 範圍的 OAI-SearchBot 只抓 robots.txt,自稱 ClaudeBot 的請求反覆抓 robots.txt 與 sitemap.xml,兩者都沒有請求過 llms.txt。附帶一提,紀錄裡大量自稱 GPTBot 的請求其實在找 .env 這類機密檔,IP 也不在 OpenAI 公布的範圍內。User-Agent 可以偽造,要判斷是不是真的 AI 爬蟲,得比對官方公布的 IP 範圍。
關於 llms.txt 的四個常見誤解
- 放了,AI 就會引用你:Google、OpenAI、Perplexity、Anthropic 的官方說明都沒有這樣寫,Google 更寫明搜尋會忽略這類檔案。
- 可以指定 AI 怎麼介紹你:它只是一份索引。AI 怎麼描述你的網站,取決於它實際讀到的頁面內容,不是檔案裡的形容詞。
- 寫上更新日期能提高權重:規格裡沒有日期欄位,也沒有任何權重機制。
- 要定期手動更新:頁面沒有增減就不必動;改用程式依頁面清單產生,上架或下架時會自動跟上。
該不該做 llms.txt?
可以做,理由是成本低,不是效果。本站的 /llms.txt 就是由程式依文章清單自動產生,新增文章就跟著更新,維護成本是零。
不建議的是花錢請人做,或把它當成 GEO 的主要手段。要被 AI 搜尋看到,先確認搜尋爬蟲進得來、內容寫得比別人具體,這兩件事都有官方依據,它目前沒有。哪些做法有依據,見〈SEO 優化指南 2026〉。
我們怎麼做?
我們的做法分兩步。第一步是不收費的初步判讀:寫信附上網址,我們回你 robots.txt 有沒有擋到 AI 搜尋爬蟲。第二步是顧問諮詢,單獨報價:做完整健檢、排出修正順序,報告歸你所有,拿去給其他廠商比價也可以。確認後才報執行價。服務內容見技術 SEO 健檢。
常見問題
llms.txt 是什麼?
llms.txt 是 Jeremy Howard 在 2024 年 9 月提出的提案:在網站根目錄放一份 Markdown 檔,用簡短說明加連結清單,讓大型語言模型需要時讀到網站重點。它不是搜尋引擎的收錄規則。
llms.txt 是官方標準嗎?
不是。它是公開在 llmstxt.org 的社群提案,不像 robots.txt 有 RFC 9309 這樣的正式標準。有些 AI 公司會在自己的開發者文件放 llms.txt,但那是發布,不代表它們的爬蟲會讀你的。
llms.txt 對 SEO 有幫助嗎?
對 Google 搜尋沒有。Google 的生成式 AI 優化指南寫明,這類檔案對搜尋的能見度與排名既不會有幫助、也不會有傷害,因為 Google 搜尋會忽略它們。
llms.txt 可以擋 AI 爬蟲嗎?
不行。llms.txt 裡沒有任何封鎖語法,只是一份給 AI 讀的索引。要擋爬蟲,要用 robots.txt 或防火牆。
llms.txt 格式要怎麼寫?
第一行用 H1 寫網站或專案名稱,這是唯一必填;接著可以放一段引言摘要、補充說明,再用 H2 分段列連結清單,每項寫成 Markdown 連結,後面可加冒號與說明。慣例上,次要內容放在名為 Optional 的段落。