「花幾十萬買台伺服器、裝開源模型自己訓練,AI 就懂公司的事,資料也不外流?」這是不少老闆評估地端 AI 時的想法。我們的結論是:對多數中小企業,自建沒有必要。要 AI 問答、寫作,串 Claude、Gemini 這類雲端大模型更準也更新;要做團隊知識庫,Gemini Notebook(原 NotebookLM)這類現成服務就夠。需要 RAG 加自建的,是文件多、線上 AI 客服量大、又受法規約束的大型企業。真的有需求,也要評估清楚再買,否則只是花大錢買一台能力不如雲端旗艦、最後擺著的機器。
自建地端 AI 有沒有意義?先看你要拿它做什麼
| 要做什麼 | 建議 | 為什麼 |
|---|---|---|
| 一般問答、寫作、摘要 | 雲端大模型的企業方案或 API | 能力排行前段,而且持續換代(見下一節) |
| 團隊內部知識庫 | Gemini Notebook(原 NotebookLM)公司帳號 | 依上傳文件回答並附出處;Workspace 帳號的內容不經人工審查、不用於訓練 |
| 大量文件+線上 AI 客服+法規限制 | RAG,評估自建或混合 | 見本文後段〈誰才需要 RAG 加自建?〉 |
| 固定格式的窄任務(分類、抽取) | 可考慮小模型微調 | 見下一節的例外 |
小模型自己訓練,為什麼比不上 Claude、Gemini?
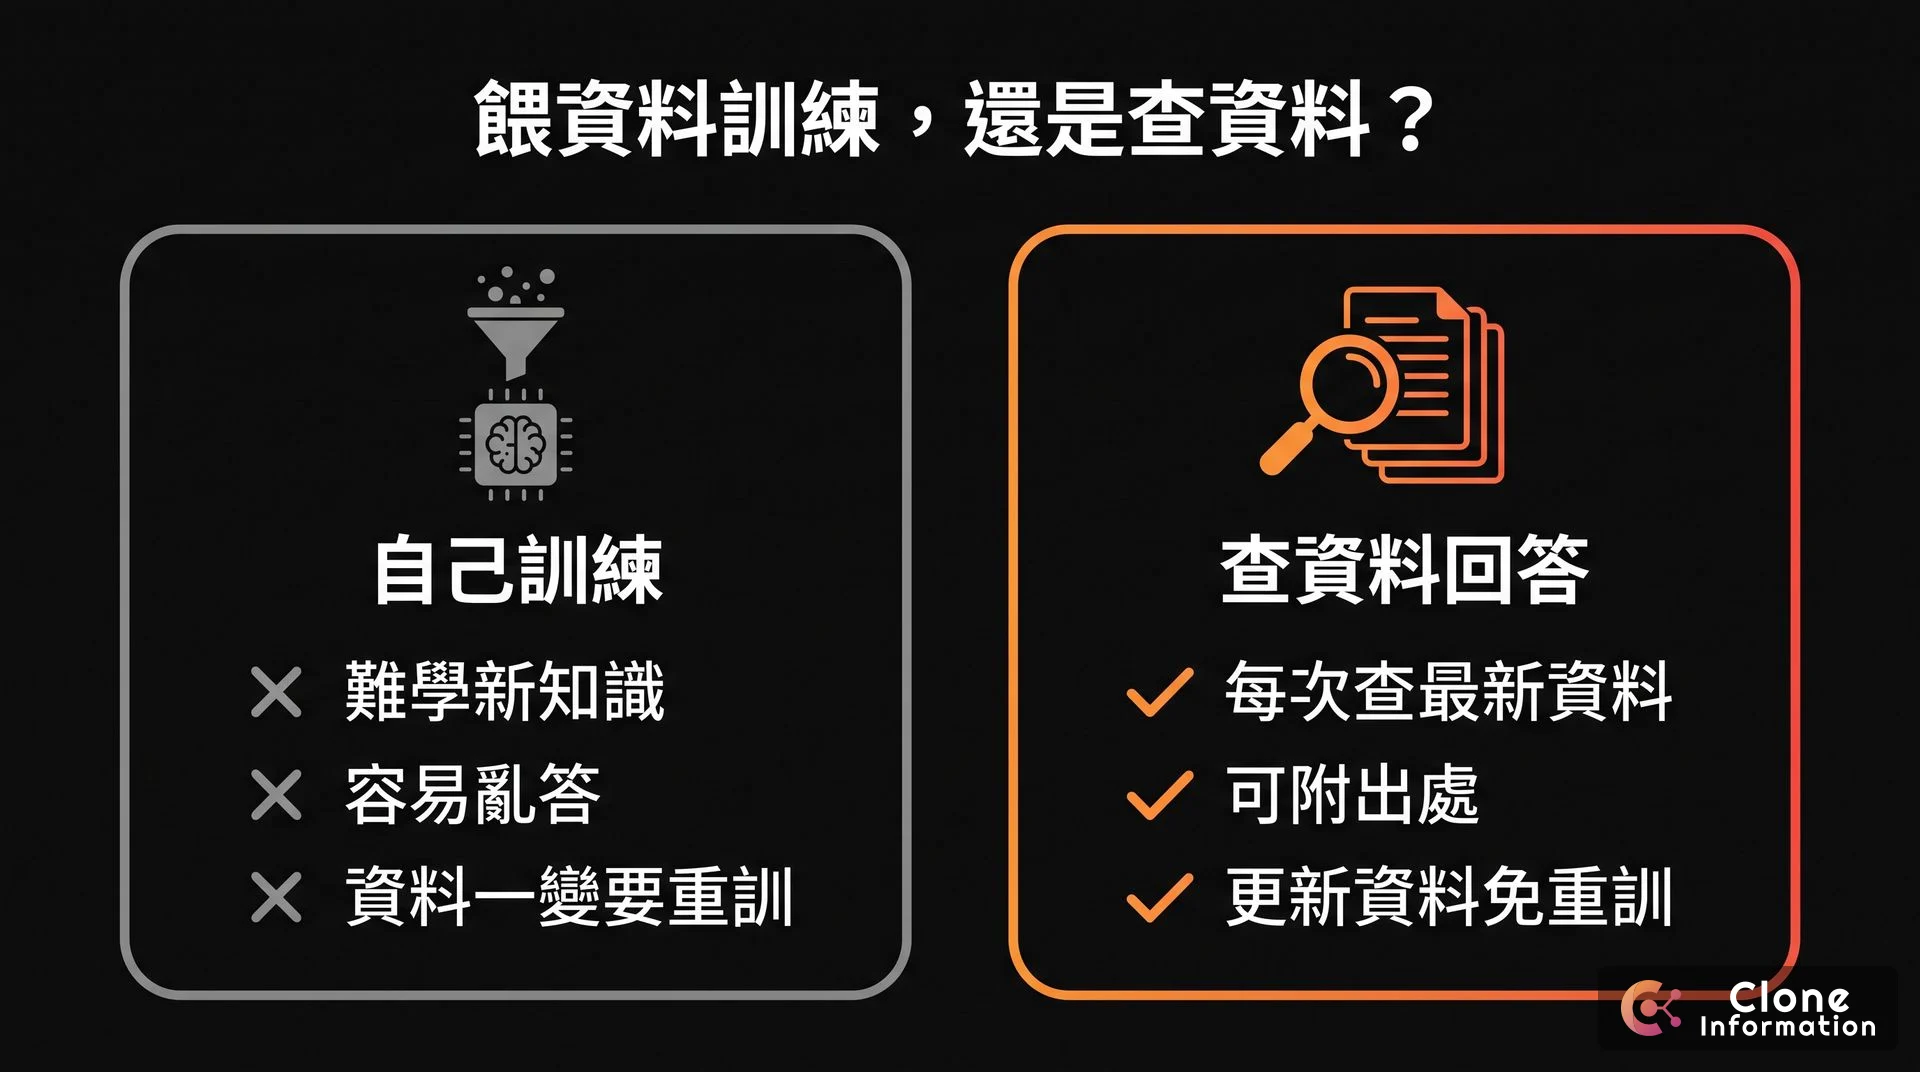
企業做得到的「自己訓練」是微調,用公司資料調整現成開源模型;從頭訓練是模型公司的事。微調能不能灌進公司知識?
| 研究 | 結論 |
|---|---|
| Ovadia 等(微軟,EMNLP 2024) | 灌知識時,RAG 一致勝過非監督式微調;模型很難靠微調學會新事實 |
| Gekhman 等(Google 研究院等,EMNLP 2024) | 新知識學得比較慢,學會之後模型亂答的傾向跟著線性增加 |
| Lewis 等(RAG 原始論文,NeurIPS 2020) | 換掉檢索的資料就能更新知識;只靠參數的模型要重新訓練 |
常聽到的「開源只落後 3.4%」出自 Stanford AI Index 2026,比的是 2026 年 3 月最強的開放權重模型 GLM-5:7,440 億參數,官方部署範例用 8 張 GPU。強的開源模型都很大;公司放得進自己機器的,是 Qwen、Llama、Gemma 這類幾十億到三百億參數的模型。同一份排行上的位置:
| Arena 文字排行(2026-10-02) | 類型 | 名次 | 分數 |
|---|---|---|---|
| Claude Opus 5.5(high) | 雲端旗艦 | 4 | 1504 |
| Gemini 3.8 Flash(high) | 雲端 | 8 | 1495 |
| Kimi K3 | 開放權重,2.8 兆參數 | 16 | 1488 |
| GLM-5 | 開放權重,7,440 億參數 | 63 | 1458 |
| Gemma 4 31B | 開放權重,工作站放得下 | 76 | 1453 |
| Qwen3.8-27B | 開放權重 | 99 | 1438 |
| gpt-oss-20b | 開放權重,16GB 記憶體可跑 | 263 | 1318 |
| Llama 3.1 8B | 開放權重 | 340 | 1211 |
差距最明顯的是 16GB 放得下的那一級。Qwen3.5 的 9B、4B 未上這份排行,官方模型卡比的是 gpt-oss、GPT-5-Nano、Gemini 2.5 Flash-Lite,沒有列雲端旗艦。雲端模型也比較新:Gemini API 更新紀錄上,Flash 在 2026 年 5 月到 9 月推出 3.5 到 3.8 四代;自建的模型買下那天就停住,要自己換版。
| 自建小型開源模型 | 雲端旗艦(企業方案、API) | |
|---|---|---|
| 服務可用性 | 一台機器就是單點故障,壞了自己修 | 機器由供應商維運,也會出狀況,例如 Claude 有公開狀態頁 |
| 模型版本 | 自己鎖住,不會被換掉 | 會停用:Gemini 3 Pro 預覽版不到四個月就停用 |
| 斷網時 | 仍可使用 | 無法使用 |
例外是窄任務。Google 與 OpenAI 的文件把微調放在提示難以描述的格式與行為,例如分類、特定輸出格式;Predibase 2024 年的技術報告,31 項任務上微調的小模型平均比 GPT-4 高 10 分,但它是賣微調服務的廠商,比的是當年的 GPT-4。
自建地端 AI 要花多少?買來沒用也在攤提
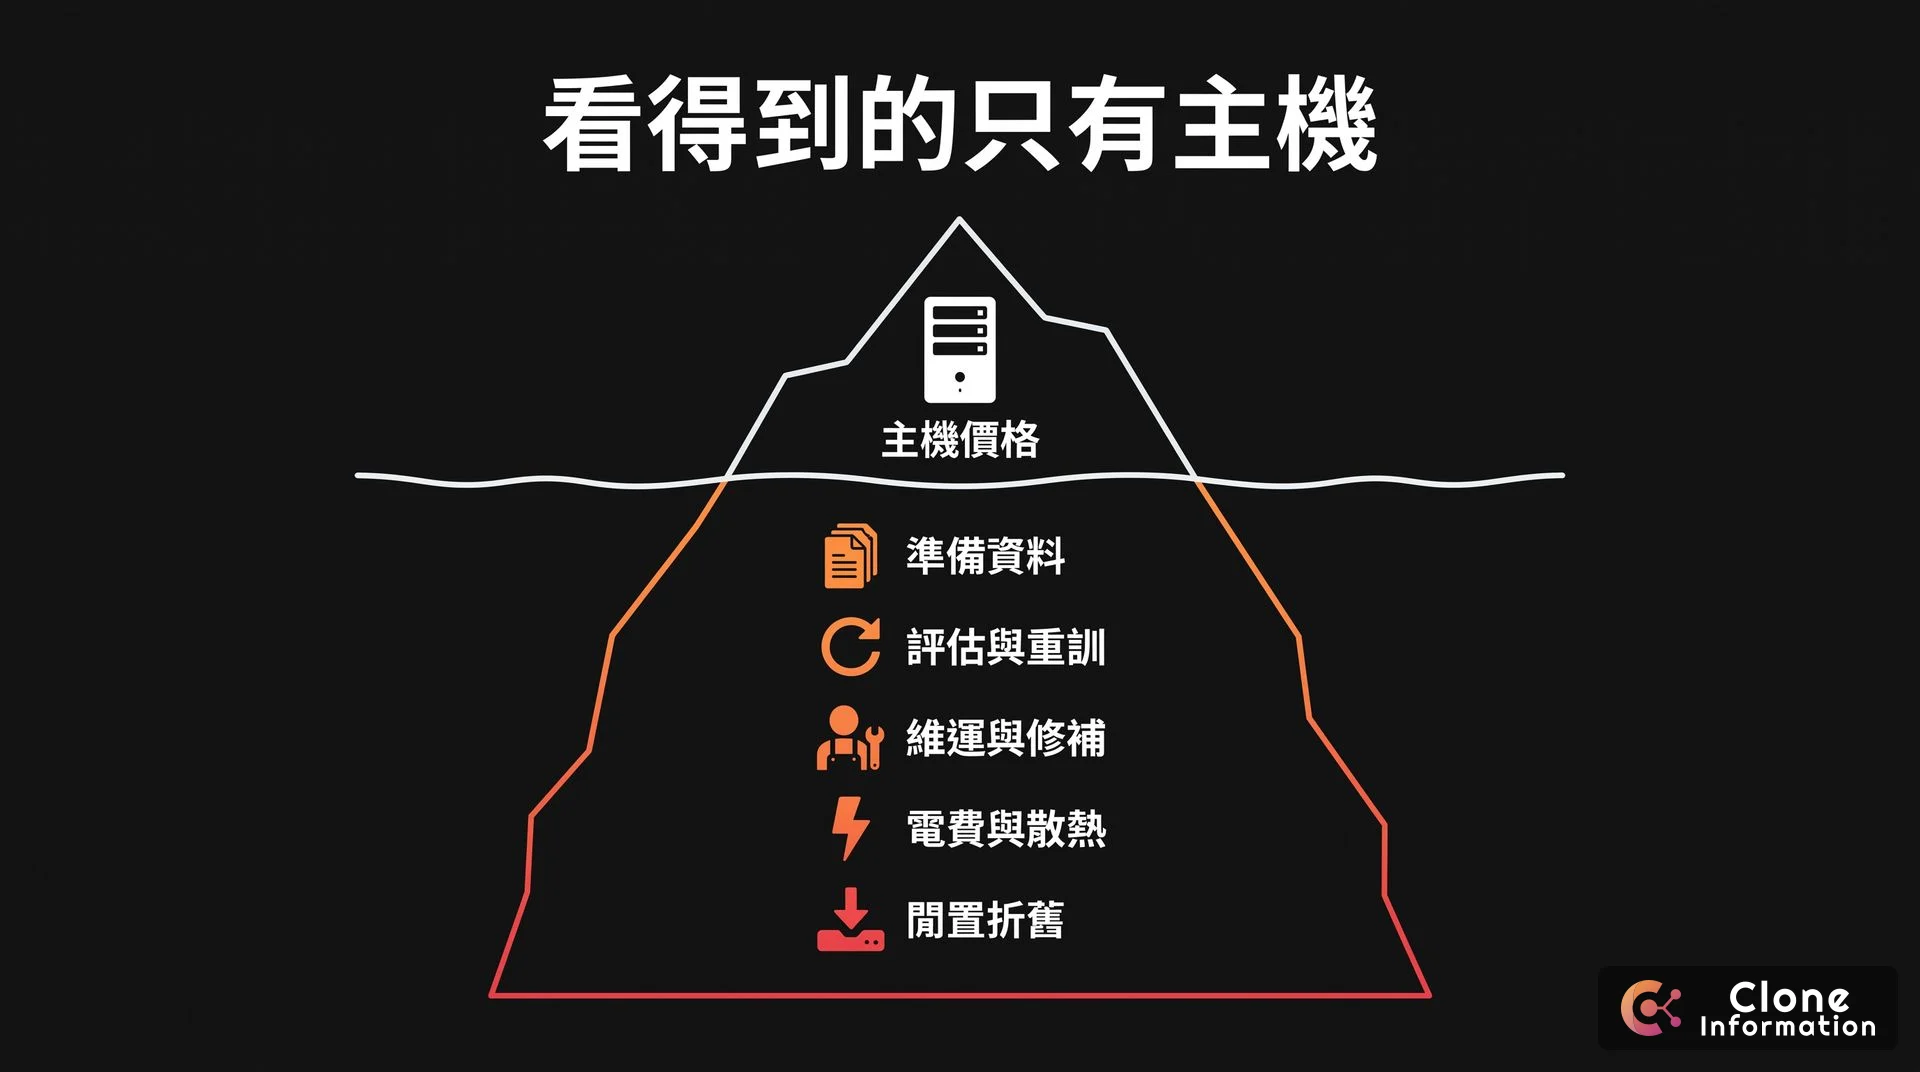
訓練本身不是大錢:QLoRA 論文在單張 48GB GPU 上微調 650 億參數模型,OpenAI 說 gpt-oss-20b 用消費級硬體就能微調。大錢在準備訓練資料、建立評估與資料一變就重訓。買機器跑地端 AI 的帳,以有台灣官方標價的 Mac Studio 試算(價格皆 2026-10-03 查詢):
| 項目 | 假設與來源 | 每月 |
|---|---|---|
| 硬體攤提 | Mac Studio(M5 Ultra、96GB)台灣官網 NT$199,900 起,分 36 個月 | 約 NT$5,550 |
| 電費(上限) | 480W 滿載 24 小時 × 30 天=345.6 度;台電營業用電每度 2.28–7.43 元 | 約 NT$790–2,570 |
| 合計 | 不含人力、資料準備、空調與備份;以臺灣銀行即期賣出 31.905 換算 | 約 NT$6,340–8,120(US$199–255) |
| 等於 Gemini 3.8 Flash | 2027 年起輸出價每百萬 token US$7.50 | 約 2,650 萬–3,390 萬輸出 token |
| 等於 Claude Opus 5.5 | 輸出價每百萬 token US$20 | 約 990 萬–1,270 萬輸出 token |
每月 API 帳單到不了 US$199–255,這台機器三年內攤不回來;沒人用時它照樣在攤提。雲端還在降價:Epoch AI 估算同一能力的推論價格每年降 9 到 900 倍。
誰才需要 RAG 加自建?
文件量大、線上 AI 客服量大、又受法規約束的大型企業。台灣企業的官方說法:
| 企業 | 官方公開說法 | 日期 |
|---|---|---|
| 鴻海研究院 | 以 Llama 3.1 為基礎訓練 70B 的 FoxBrain,NVIDIA 以 Taipei-1 超級電腦支援,120 張 H100 約四週 | 2025-03-10 |
| 國泰金控 | 採用 NVIDIA NeMo 平台訓練台灣金融授信大型語言模型 | 2025-05(10-23 新聞稿) |
| 玉山銀行 | 內部平台 GENIE 連接各 LLM 廠商的模型,以 RAG 查行內知識庫,並用閘道在輸出前偵測與替換敏感資料 | 2025-08-29 |
| 中華電信 | 結合自主與雲端 AI 平台 | 2025-06-25 |
這些是集團規模的做法:玉山自建平台與知識庫、模型接外部廠商,中華電信自主與雲端 AI 平台並用。中小企業值得評估自建的情況是:
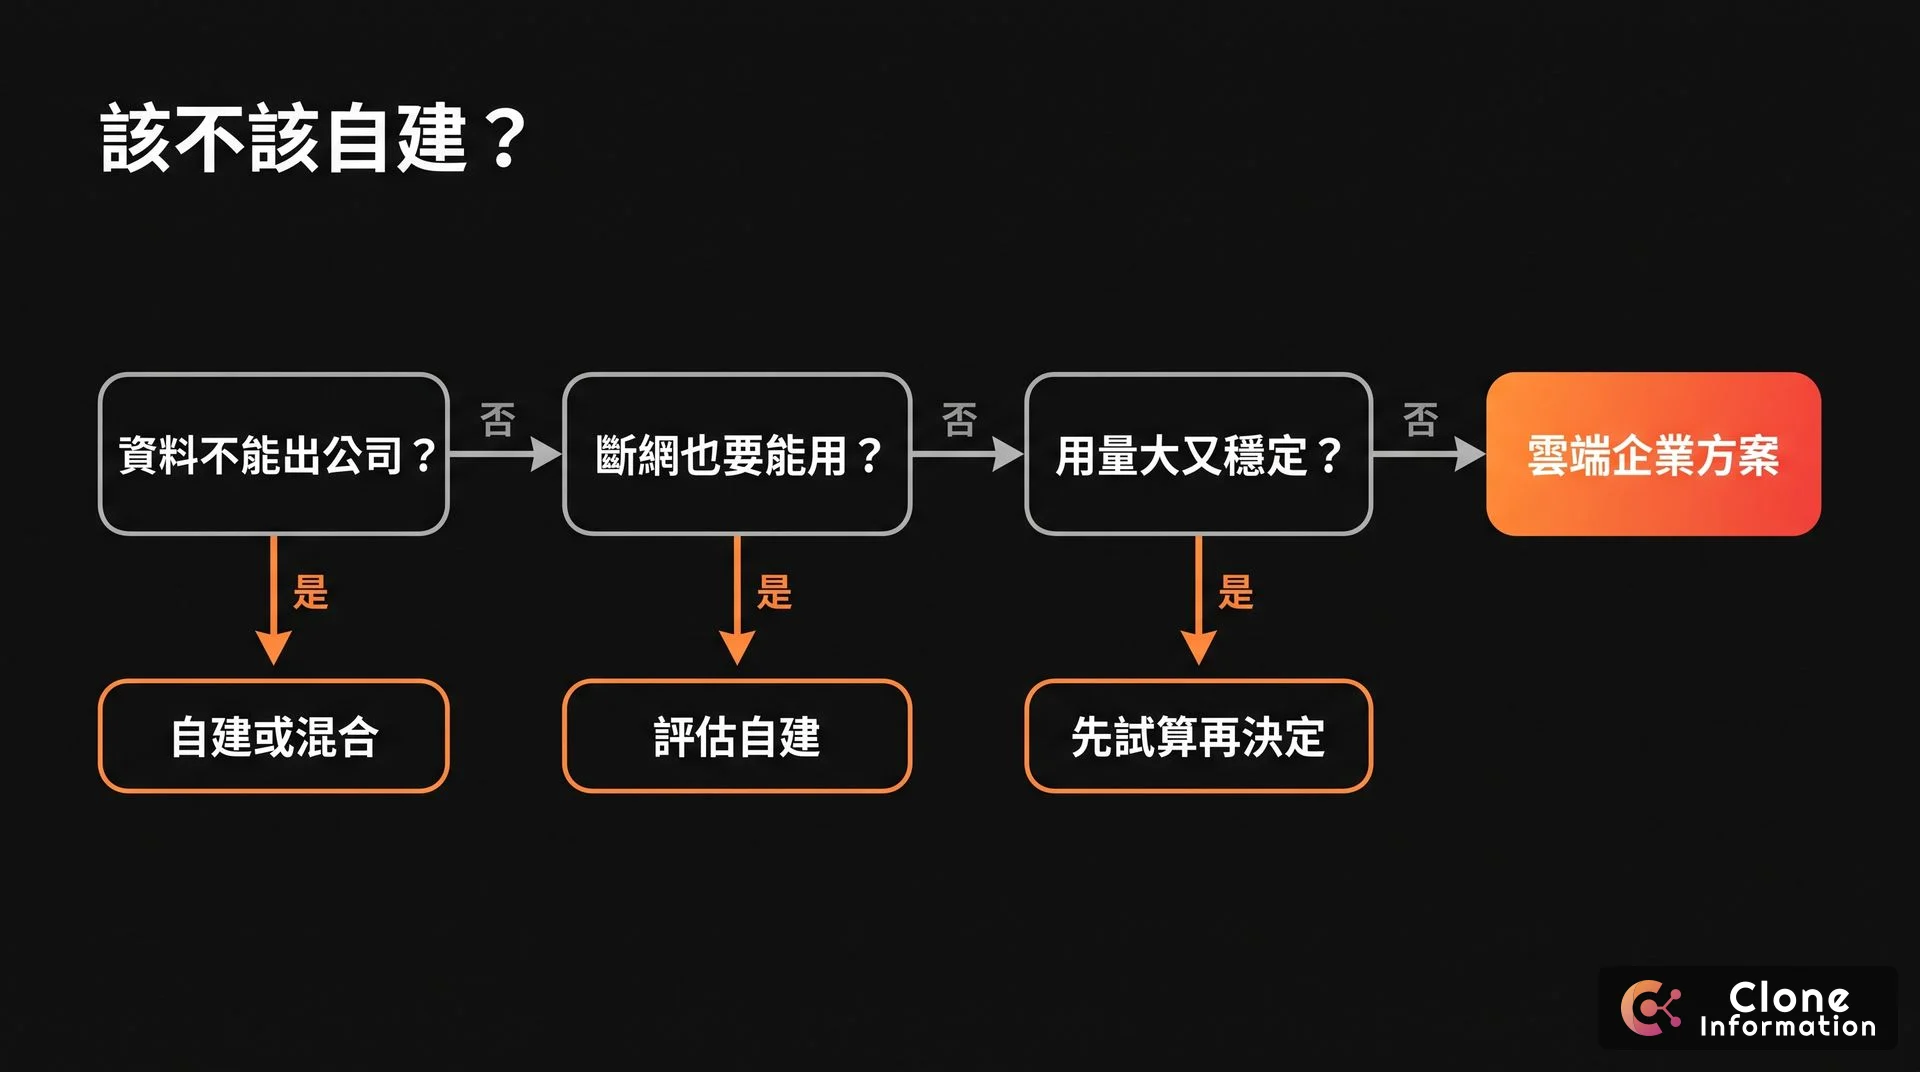
- 資料依法規或合約不能離開公司或台灣。 雲端在台灣就地處理的選項很少(見下表)。金管會〈金融業運用人工智慧(AI)指引〉寫明無適當管控機制時,不得向生成式 AI 提供未經客戶同意提供之資訊,管控機制「例如採用封閉型部署之生成式 AI 模型、確認系統環境安全性等」,封閉型部署只是例子之一。
- 必須斷網運作。 產線或現場系統斷網時仍要能用。
- 用量大且穩定,又有人負責評估、重訓與換版。
| 雲端服務 | 能否在台灣就地處理(截至 2026 年 10 月) |
|---|---|
| OpenAI API | 資料落地區域在亞洲有日本、新加坡、南韓、印度,沒有台灣;這些區域只保證儲存,推論可能在區域外 |
| Google Cloud | 台灣區域沒有 Gemini 生成模型;官方承諾在台灣處理的生成模型只有 Claude Haiku 4.5 與 Sonnet 4 |
| AWS Bedrock | 台北區域列出的模型都不支援區域內處理,依設定送往其他區域 |
真的要自建地端 AI,先回答哪幾個問題?
| 先回答 | 為什麼 |
|---|---|
| 使用者是誰、同時幾人 | 人越多,需要的記憶體與算力越大,桌上型工作站可能不夠 |
| 要它做什麼 | 回答公司的事先做 RAG;固定格式的任務才考慮微調 |
| 用量多大 | 每月 API 帳單到不了上表那條線,買機器攤不回來 |
| 評估了沒 | 先用測試或去識別的資料,在雲端試跑同一個開源模型;gpt-oss 在 AWS Bedrock 也能按用量呼叫 |
| 誰維運與換版 | 更新、修補、評估、重訓都要有人做 |
| 授權與模型來源 | 見下表;客戶是公務機關要特別注意 |
| 模型 | 授權 | 要注意的 |
|---|---|---|
| Qwen3.5 小模型、Qwen3.8-27B | Apache 2.0 | 同代的 Qwen3.8-Flash-Next 改用 Qwen 社群授權,經營模型服務等事業要另取授權 |
| OpenAI gpt-oss | Apache 2.0 | 寬鬆授權,可商用 |
| Google Gemma 4 | Apache 2.0 | 舊版 Gemma 適用另一份使用條款:Google 認定違約時,保留遠端限制使用的權利 |
| Meta Llama 4 | Llama 4 社群授權 | Llama 4 發布時月活躍用戶已超過 7 億的公司要另向 Meta 申請;散布或對外提供含 Llama 的產品,要明顯標示 Built with Llama |
| DeepSeek | 依各模型 | 數位發展部列為危害國家資通安全產品;資通安全署 2025-02-20 說明公務機關「包含雲端服務、APP及地端下載等方式」皆不得使用,當時未限制民間 |
不自建,怎麼讓 AI 用公司資料又不外流?
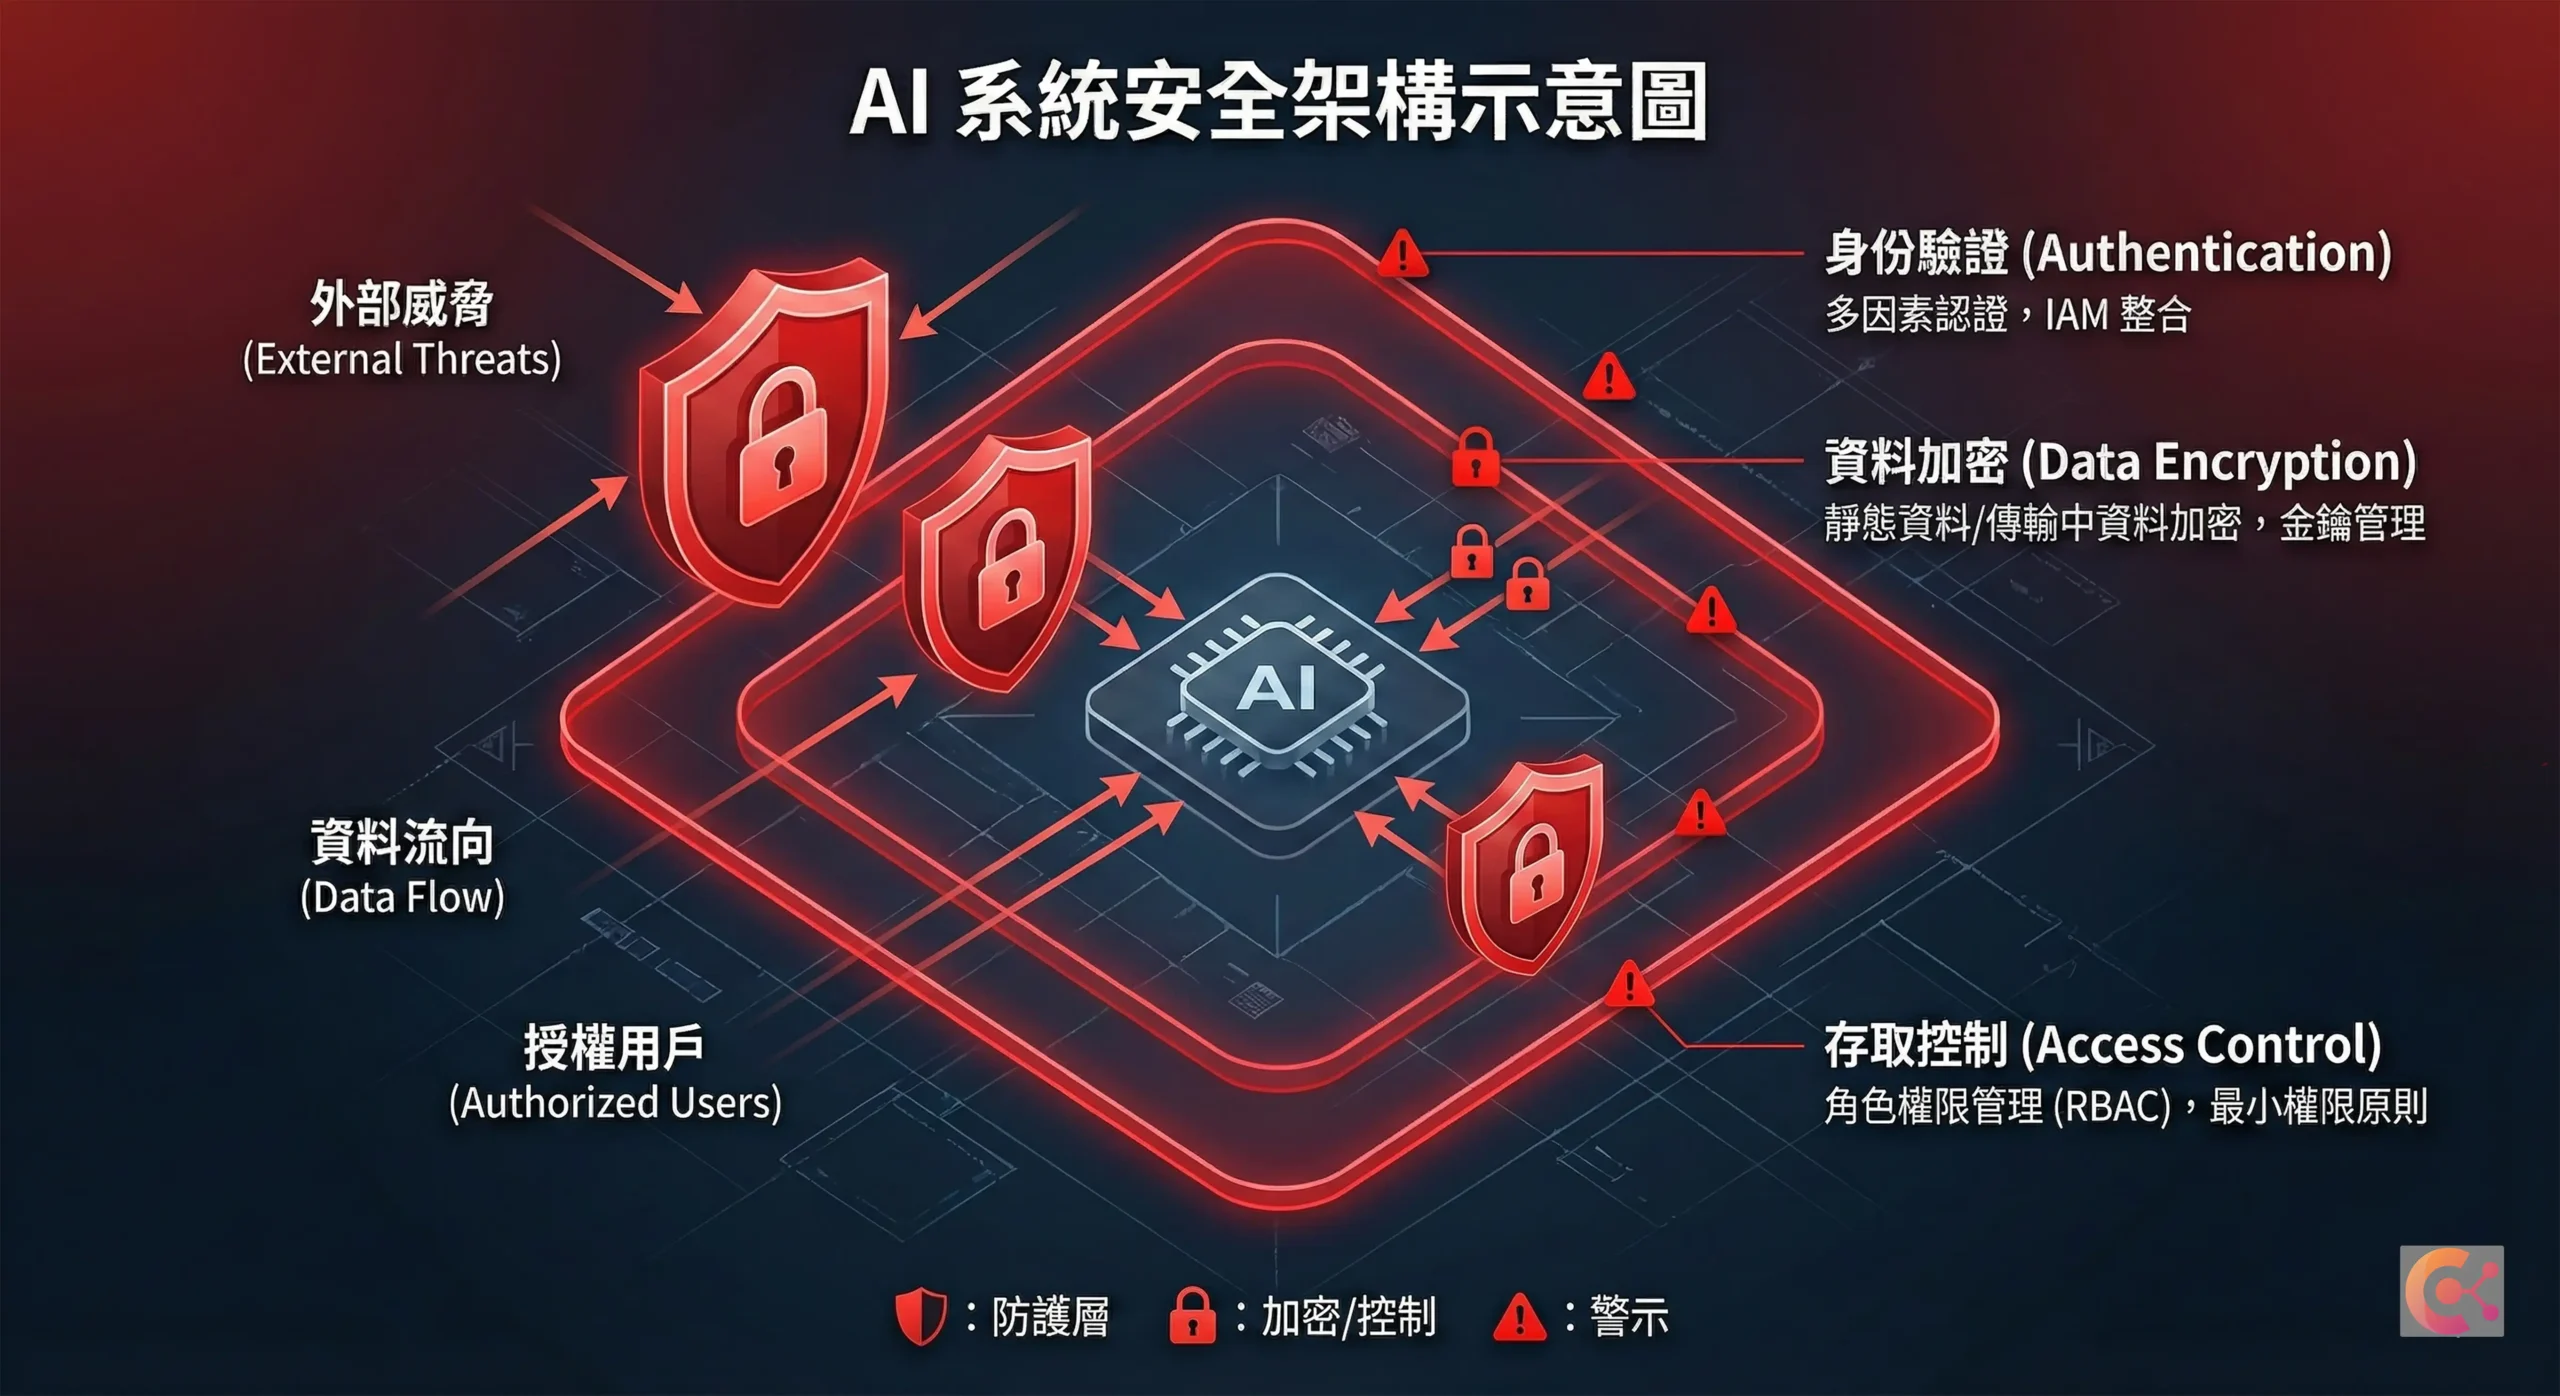
- 用企業方案或 API,不用個人帳號。 各家企業方案預設不用客戶資料訓練(見常見問題)。
- 知識庫用公司帳號。 Gemini Notebook 的 Workspace 帳號內容不經人工審查、不用於訓練;沒有公司帳號,先別上傳機密文件。要同時查公司系統、控管誰能用,見 AI 流程自動化 的 Dify 導入。
- 只讓 AI 看到需要的資料。 查 ERP 時,我們讓 AI 只能呼叫寫死的唯讀查詢工具,每次查詢留稽核紀錄(案例,功能實作中)。
- 流程與金鑰開在你的帳號。 n8n 自架在你自己的雲端專案;內部系統只開受控通道的做法見企業雲端建置與資安防護。
我們怎麼做?
真的有自建需求,更要先評估清楚:要不要自建、自建哪一段、規模多大;現成工具就夠的,我們也會直說。模型與雲端費用直接開在你的帳號,我們不經手、不加成。做法分兩步。
第一步是不收費的初步判讀:寫信說明誰要用、要做什麼、用量多少與合約限制,我們回你適合雲端企業方案、混合架構,還是值得評估自建。還沒選定工作,先用〈AI 導入說不出成效?〉挑一步。
第二步是顧問諮詢,單獨報價:盤點流程與資料從哪來到哪去、用實際用量試算並建立 SOP,交付 SOP 文件與軟體設計需求單。文件歸你所有,結論是自建也一樣,可以拿去給其他廠商比價;要我們接手的部分,確認後才報執行價。服務內容見 AI 流程自動化。
常見問題
中小企業需要自建地端 AI 嗎?
多半不需要。要 AI 問答、寫作,串 Claude、Gemini 這類雲端大模型更準也更新;要做團隊知識庫,Gemini Notebook(原 NotebookLM)這類現成服務就夠。法規要求資料不能出公司、必須斷網,或文件與客服量都很大,才值得評估自建。
拿小型開源模型餵公司資料訓練,有用嗎?
要它學會公司的知識,效果有限。微軟研究者在 EMNLP 2024 的實驗中,讓模型查資料(RAG)一致勝過非監督式微調,模型也很難靠微調學會新事實;Google 研究者同年發現,硬學新知識會讓模型更容易亂答。固定格式的分類、抽取才適合微調。
要做公司知識庫,用什麼?
先試 Gemini Notebook(原 NotebookLM):上傳文件後依內容回答並附出處,台灣可用。用 Google Workspace 公司帳號時,Google 寫明上傳內容、提問與回答不經人工審查、不用於訓練 AI 模型;沒有公司帳號,先別上傳機密文件。
什麼公司才需要 RAG 加自建?
文件量大、線上 AI 客服量大、又受法規約束的大型企業,例如金融業。即使如此,玉山銀行的內部平台 GENIE 也是自建平台與知識庫、模型連接外部廠商;鴻海訓練 FoxBrain 用了 NVIDIA 超級電腦上的 120 張 H100。
用雲端 AI,公司資料會被拿去訓練嗎?
企業方案與付費 API 預設不會:OpenAI、Anthropic 與 Google Cloud 都寫明預設不用客戶資料訓練,但 Gemini API 免費層會用於改善產品。不訓練不等於不保留,OpenAI API 預設保留濫用監控紀錄最多 30 天。
本文引用資料來源
- 微調與 RAG:Ovadia 等、Gekhman 等、Lewis 等、QLoRA、LoRA Land、Google 微調文件、OpenAI 微調文件
- 模型與服務:Arena 文字排行、AI Index 2026、GLM-5、Qwen3.5-9B、Qwen3.8-27B、gpt-oss-20b、Gemma 4、Gemini API 更新紀錄與停用表、Claude 狀態頁、Gemini Notebook 更名(2026-07-16)與說明
- 價格(2026-10-03 查詢):Mac Studio與規格、台電電價表、臺銀匯率、Gemini API 定價、Claude API 定價、Epoch AI
- 台灣企業:鴻海、國泰金控、玉山銀行、中華電信
- 資料與區域:OpenAI 企業隱私、OpenAI API 資料、Anthropic 資料說明、Google 訓練限制、支援區域與資料落地、Bedrock 區域與gpt-oss 模型卡
- 授權與法規:Llama 4 授權、Gemma 4 授權、Gemma 使用條款、Qwen 社群授權、數位發展部、資通安全署、金管會 AI 指引