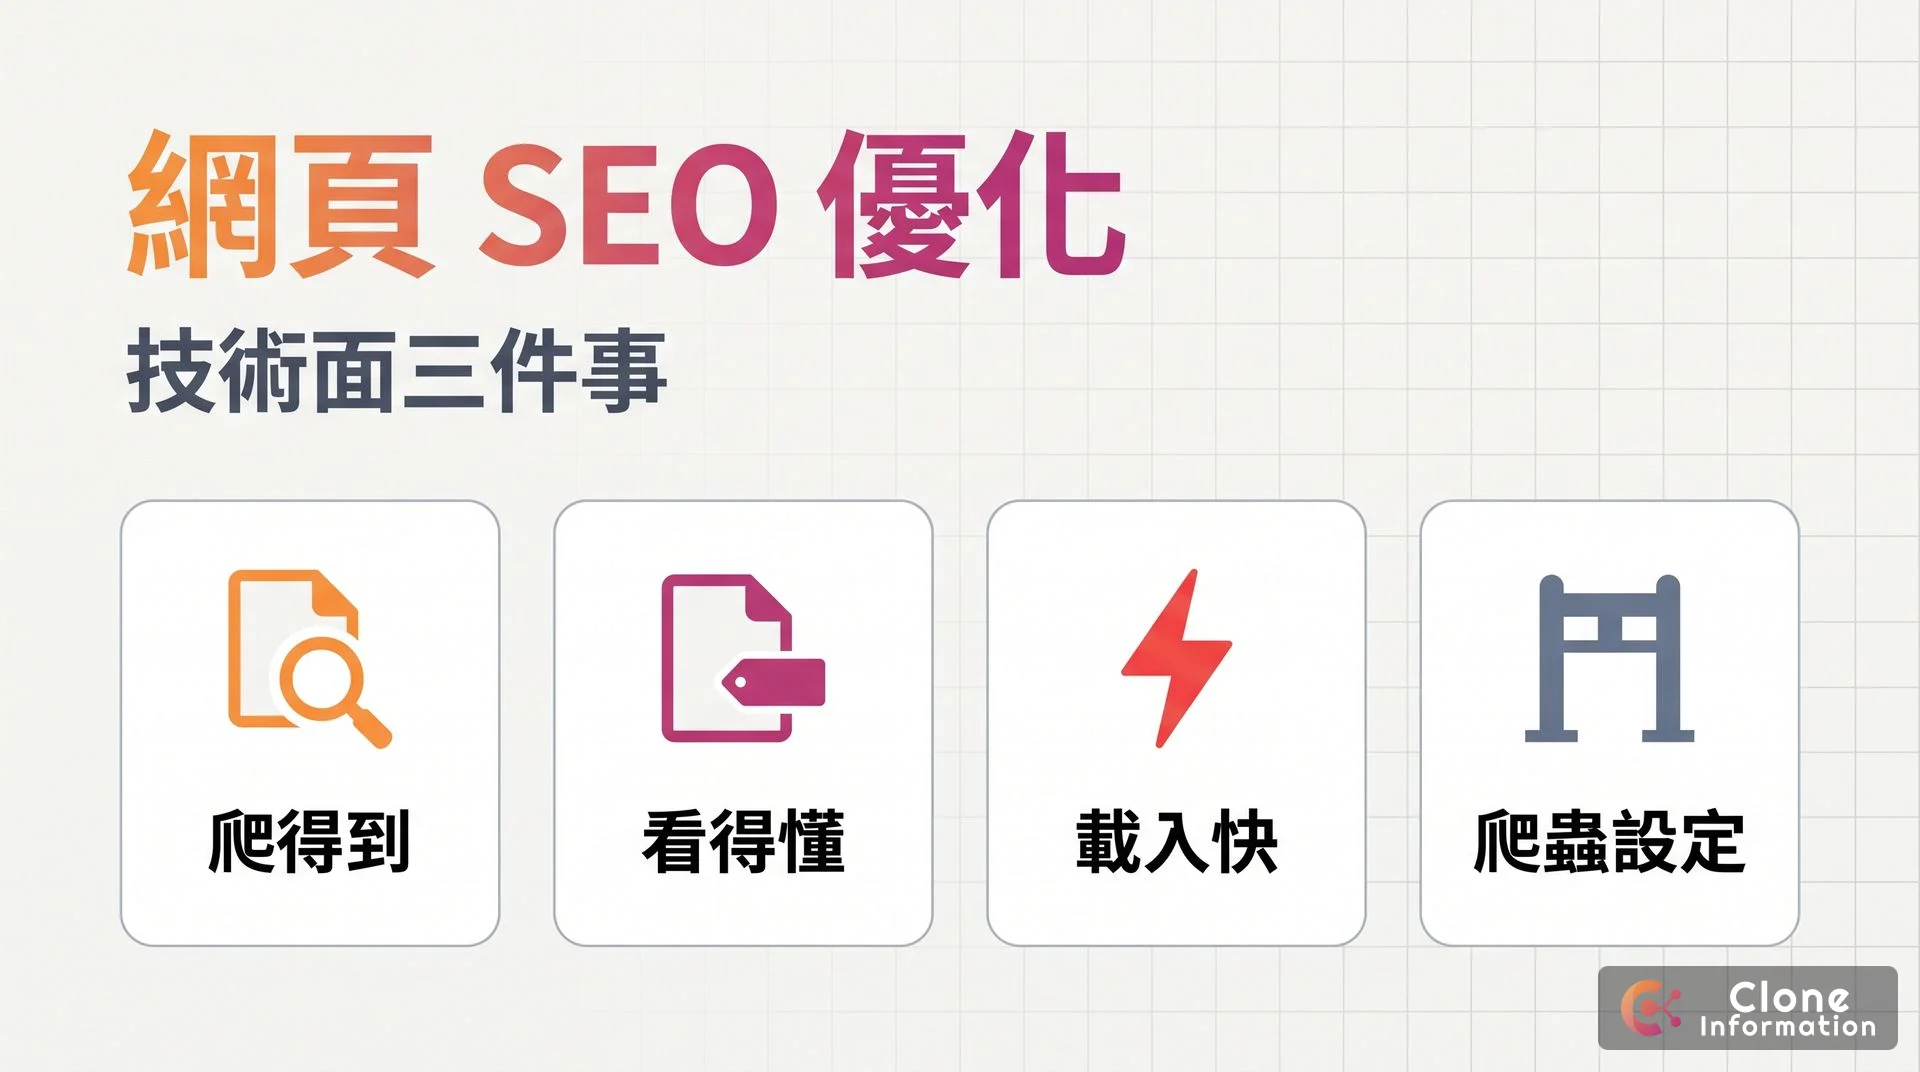
網頁 SEO 優化的技術面只有三件事:讓 Google 爬得到、看得懂、載入快。Google 的技術要求只有三條最低門檻,結構化資料只標看得到的內容,Core Web Vitals 看三項指標。這篇照這三件事,加上 robots.txt 的爬蟲設定,整理每一項的官方依據與檢查方法。
網頁 SEO 優化第一步:先確認爬得到、能收錄
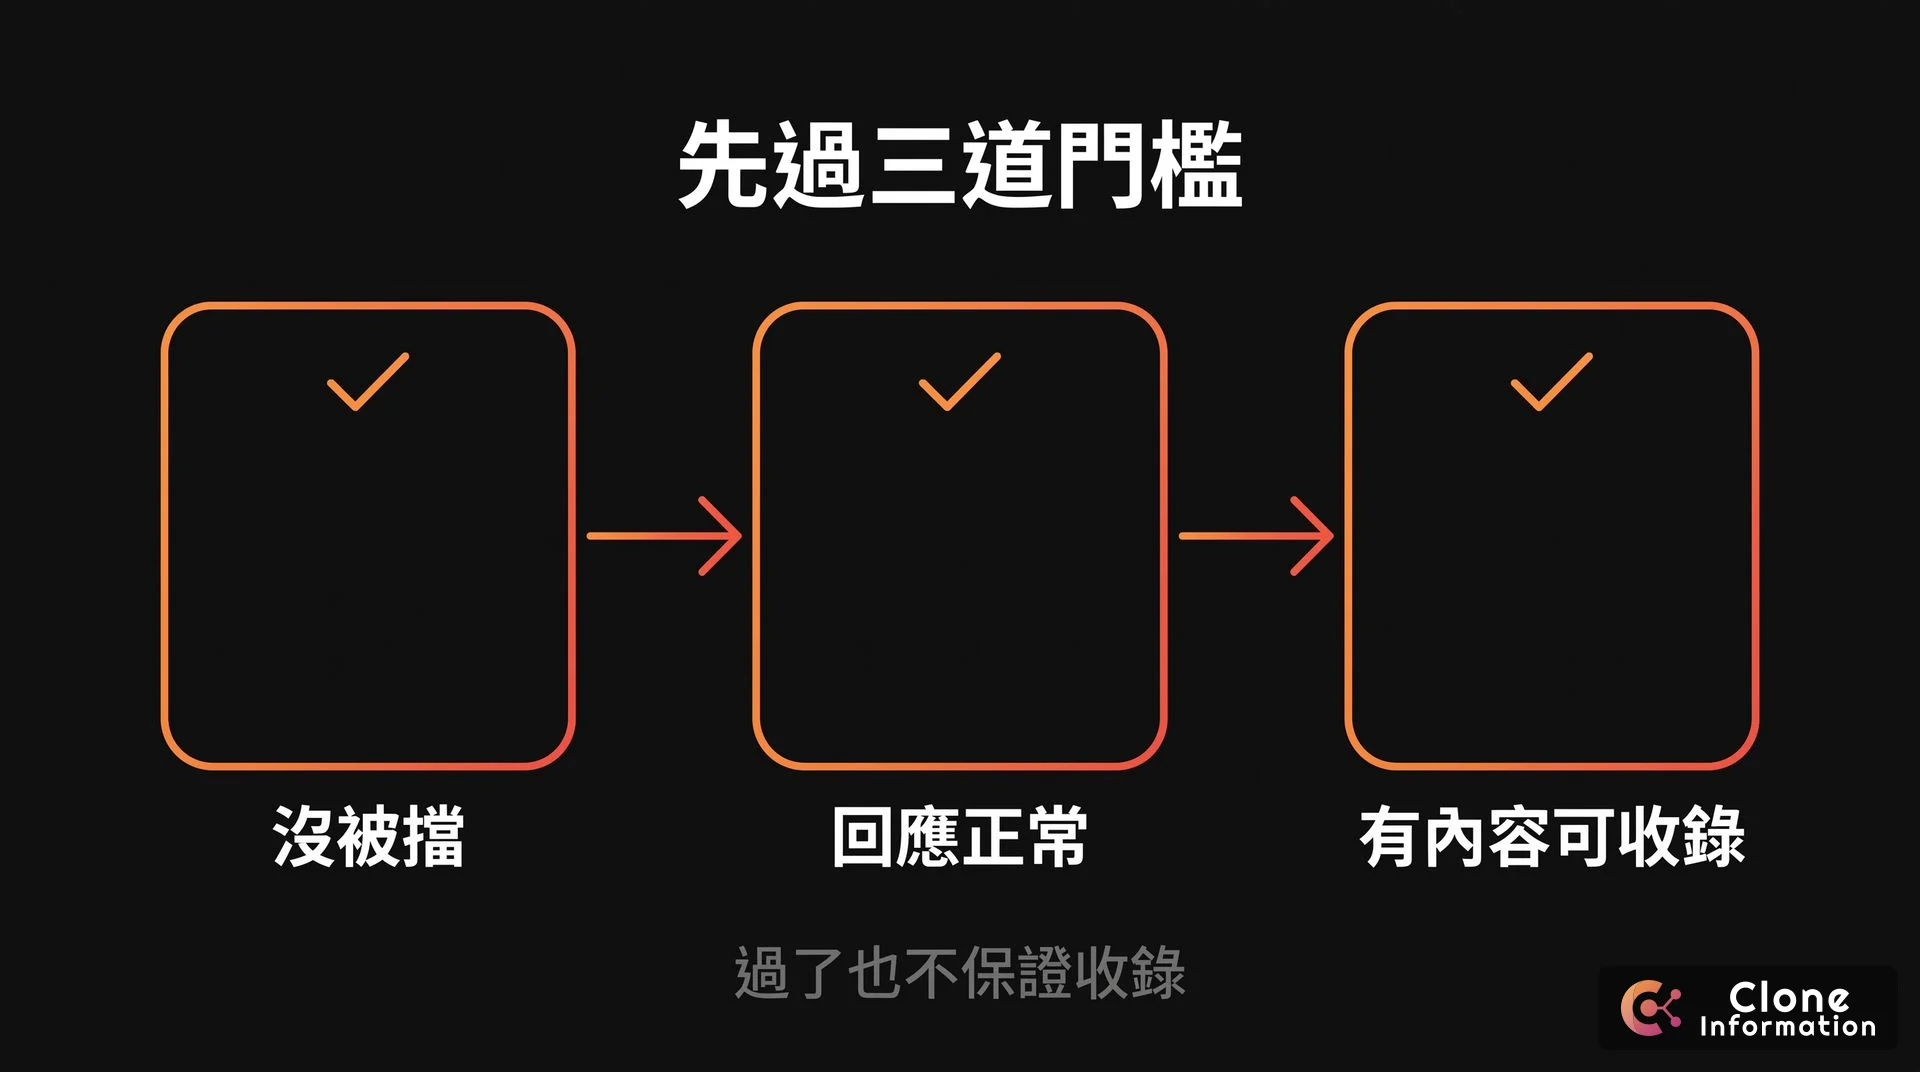
Google 搜尋基本原則列的技術要求只有三條:Googlebot 沒被擋、頁面回傳 HTTP 200、頁面有可以編入索引的內容。官方也寫明,符合這三條不保證一定收錄。
| 要檢查的 | 怎麼查 | 常見原因 |
|---|---|---|
| Googlebot 有沒有被擋 | Search Console 網址檢查 | robots.txt 寫錯、防火牆擋到 |
| 頁面是不是回 200 | 網址檢查的即時測試 | 轉址鏈、軟 404、伺服器錯誤 |
| 有沒有被編入索引 | Search Console 網頁索引報表 | noindex、重複內容、品質不足 |
| Google 選的是哪個網址 | 網址檢查裡「Google 選定的標準網址」 | 同一內容有多個網址 |
技術 SEO 常被忽略的,是同一份內容有好幾個網址:有沒有尾斜線、大小寫、追蹤參數,都會變成不同網址。網址檢查會告訴你 Google 最後選了哪一個,如果不是你要的那個,就要整理轉址與 canonical。
網站改版或搬家時更要小心。舊網址要一對一轉到新網址,目的地要寫完整,連尾斜線都要一致,否則會變成轉兩次才到。
結構化資料:只標看得到的內容
結構化資料是用 JSON-LD 告訴 Google 這頁在講什麼:是文章、是公司、還是產品。它的用途是讓頁面有資格取得複合式搜尋結果,例如麵包屑、商品價格、評分。哪些類型現在還有版位,以 Google 的複合式搜尋結果庫為準。
| 類型 | 用在哪裡 | 現況 |
|---|---|---|
| Organization | 首頁或關於頁 | 有效,可提供公司名稱、標誌等資訊 |
| Article/BlogPosting | 文章頁 | 有效 |
| BreadcrumbList | 有階層的頁面 | 有效,搜尋結果可顯示麵包屑 |
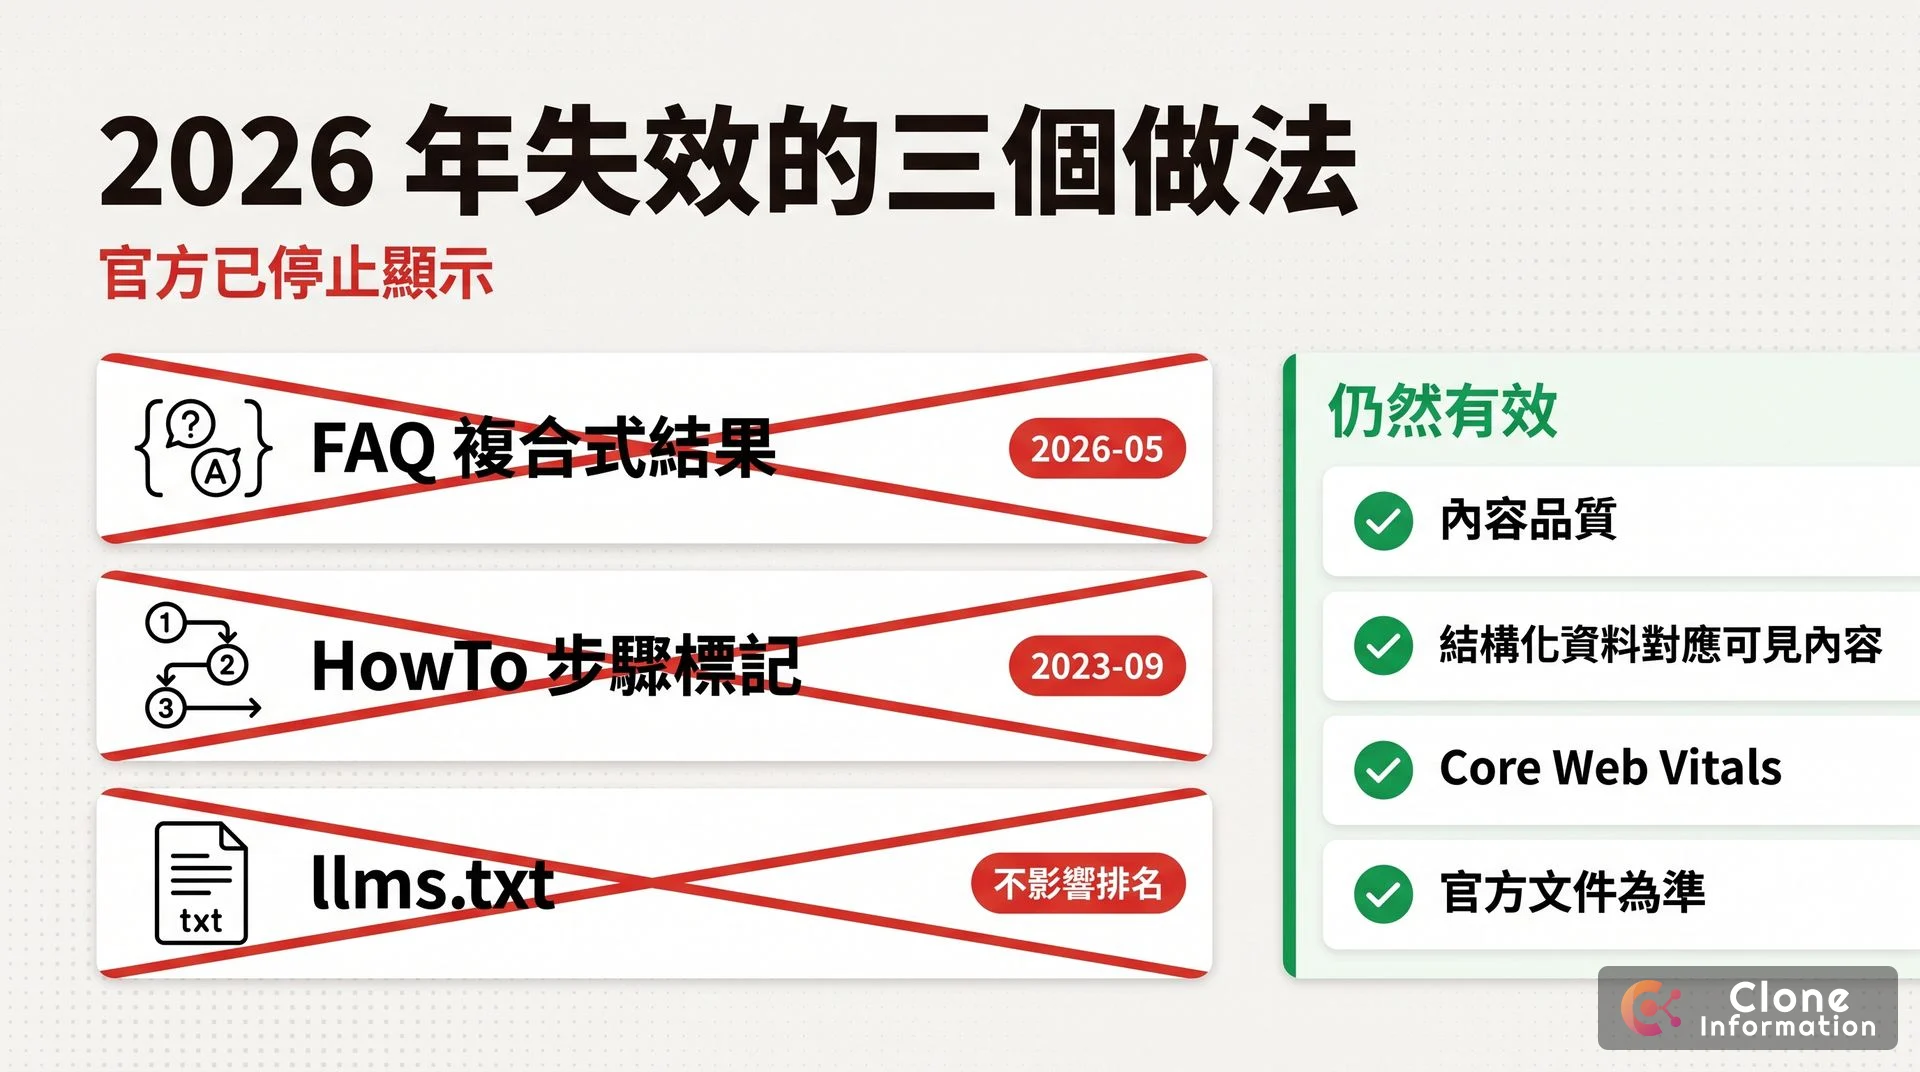
| FAQPage | 問答區塊 | 複合式結果已停止顯示 |
| HowTo | 教學步驟 | 複合式結果已停止顯示 |
最重要的規則只有一條,結構化資料總則寫明:「Don’t mark up content that is not visible to readers of the page.」標了讀者看不到的內容,可能收到手動處置;但官方也說明,結構化資料的手動處置只會讓頁面失去複合式結果的資格,不影響排名。
一個最小的文章範例:
{
  "@context": "https://schema.org",
  "@type": "BlogPosting",
  "headline": "網頁 SEO 優化怎麼做?",
  "datePublished": "2026-01-09",
  "dateModified": "2026-10-02",
  "author": { "@type": "Organization", "name": "範例公司", "url": "https://example.com/" }
}
標題、日期、作者都要和頁面上看得到的一致。修改日期只在內容真的有改時才更新,Google 的實用內容指南把「內容沒實質改變卻改日期」列為自我檢查的警訊。寫好之後,用 Google 的複合式搜尋結果測試檢查有沒有錯誤。
Core Web Vitals:三項門檻,TTFB 不在其中
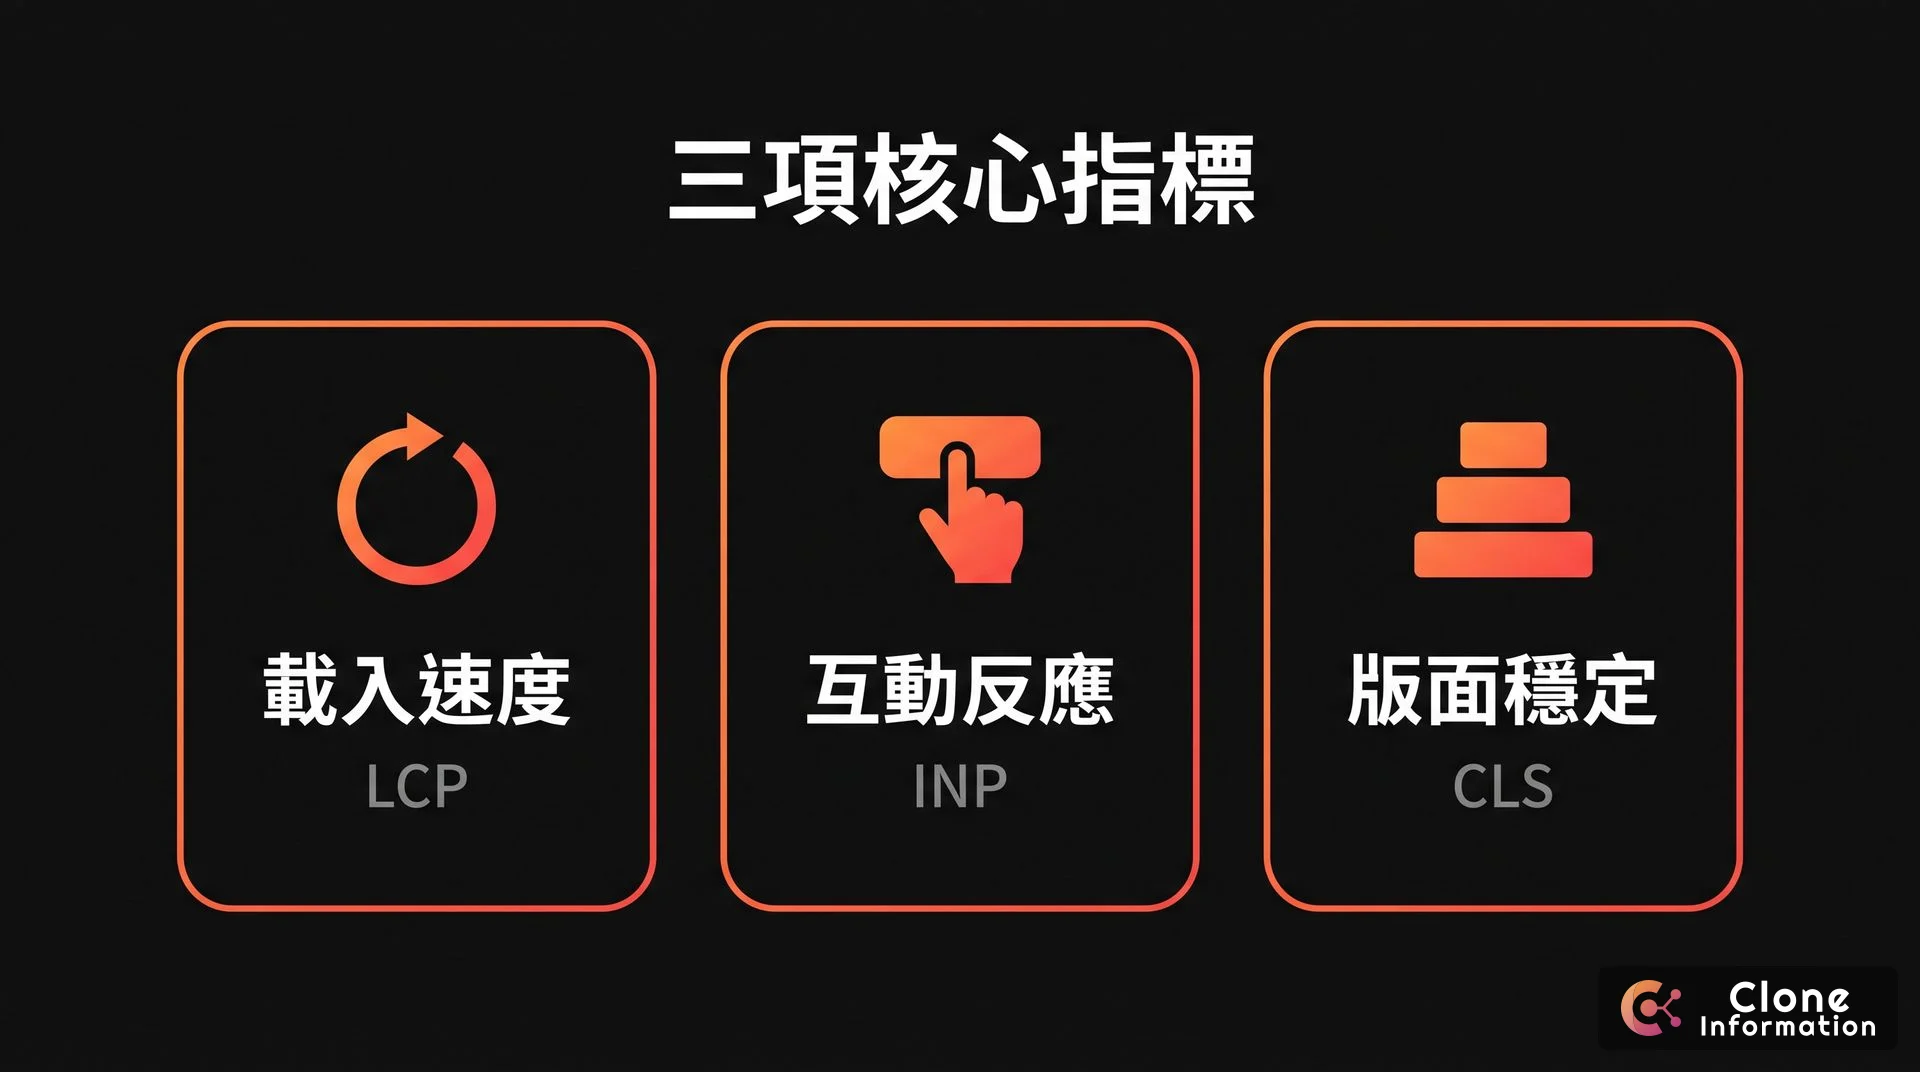
| 指標 | 量什麼 | 良好門檻 | 常見改善方式 |
|---|---|---|---|
| LCP | 主要內容多快出現 | 2.5 秒內 | 壓縮首圖、不要延遲載入首屏圖片 |
| INP | 點擊後多快有反應 | 200 毫秒以下 | 減少 JavaScript、拆分長任務 |
| CLS | 版面會不會跳動 | 0.1 以下 | 圖片寫好寬高、不要動態插入內容 |
門檻以實際使用者的第 75 百分位計算,手機與電腦分開看。所以要看的是 Search Console 的 Core Web Vitals 報表,那是真實使用者的資料;Lighthouse 的分數是單次模擬,兩者可能差很多。
TTFB 常被誤列為第四項。web.dev 寫明 TTFB 不是 Core Web Vitals 指標,大多數網站以 0.8 秒以內為目標即可。它的價值在於它是 LCP 的上游,伺服器回應慢,後面很難補回來。
Google 對 Core Web Vitals 的說法很平衡:「We highly recommend site owners achieve good Core Web Vitals for success with Search」,但同時寫明「Google Search always seeks to show the most relevant content, even if the page experience is sub-par」。速度要顧,但它補不了內容不對題。
本站的做法是不載入任何網頁字型,全站使用裝置內建字體,因為繁體中文字型檔很大,會拖慢首屏。你可以打開瀏覽器的開發者工具確認。
robots.txt:管能不能抓,不管收不收錄
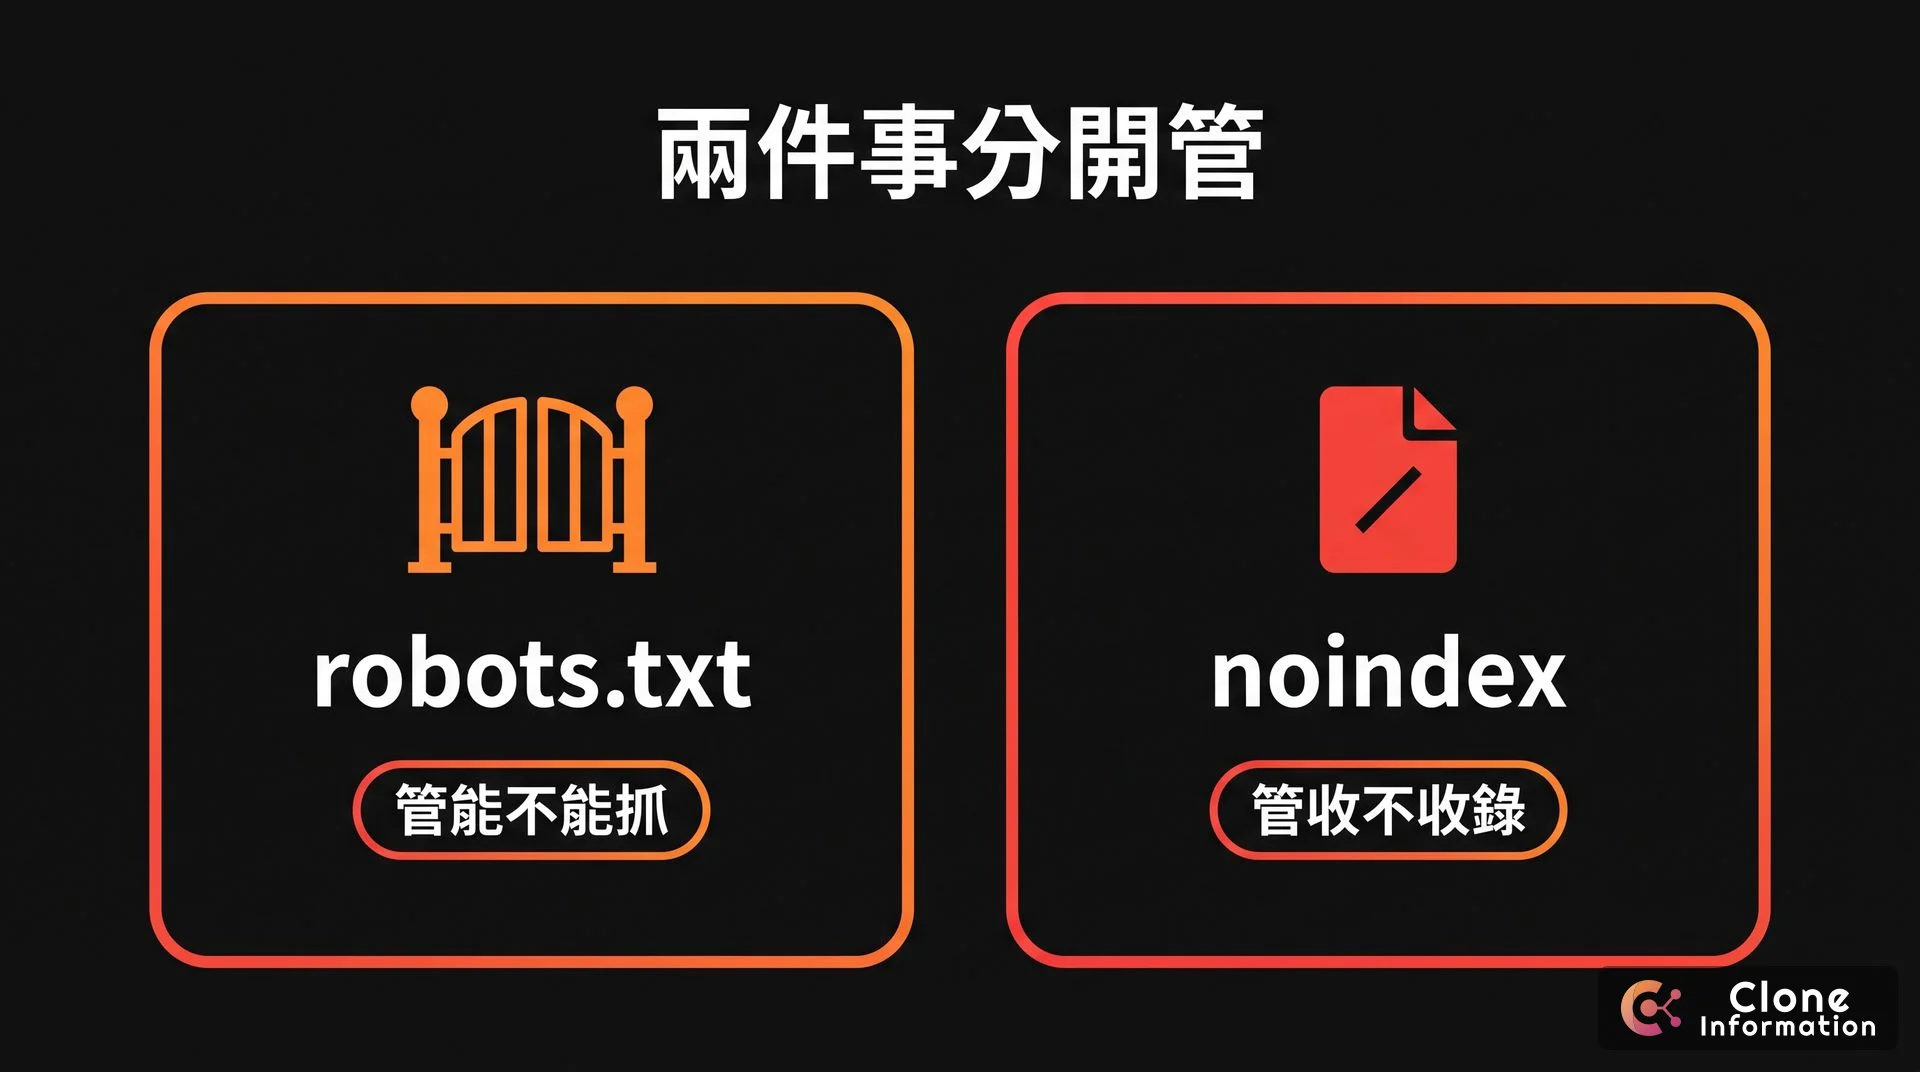
robots.txt 最常被誤用的地方,是拿它來讓頁面不出現在 Google。官方寫明它「is not a mechanism for keeping a web page out of Google」,被擋的網址如果有其他網站連過來,仍可能被收錄。要讓頁面不被收錄,用 noindex 或密碼保護。
AI 爬蟲則要分清楚用途:
| 用途 | 爬蟲 | 擋了會怎樣 |
|---|---|---|
| 搜尋 | Googlebot、OAI-SearchBot、PerplexityBot、Claude-SearchBot | 可能不會出現在該平台的搜尋結果 |
| 訓練 | GPTBot、ClaudeBot、Google-Extended | 不影響搜尋結果,可另外決定 |
| 使用者代為造訪 | ChatGPT-User、Claude-User | 使用者提問時才抓;OpenAI 說 robots.txt 可能不適用 |
Google-Extended 比較特別,它影響的是 Gemini 的訓練與 grounding,官方寫明不影響 Google 搜尋的收錄與排名。另外要注意,robots.txt 裡被點名的爬蟲只看自己那一組規則,不會再套用 User-agent: * 底下的 Disallow,詳細寫法見〈GEO 優化是什麼?〉。llms.txt 不能擋爬蟲,它的用途見〈llms.txt 是什麼?〉。
網頁 SEO 優化要用哪些工具檢查?
Google 的免費工具就夠用:Search Console 看收錄、網址與 Core Web Vitals,PageSpeed Insights 看單頁速度,複合式搜尋結果測試看結構化資料。要知道 AI 爬蟲實際來了哪些,則要看伺服器或 CDN 的存取紀錄,依 User-Agent 篩選。
我們怎麼做?
我們的做法分兩步。第一步是不收費的初步判讀:寫信附上網址與 Search Console 索引報表的截圖,我們回你卡在爬取、收錄還是速度。第二步是顧問諮詢,單獨報價:做完整的技術健檢、排出修正順序,報告歸你所有,拿去給其他廠商比價也可以。確認後才報執行價。服務內容見技術 SEO 健檢;如果問題是網站架構本身撐不住,要看的是企業官網設計與建置。哪些做法有官方依據,見〈SEO 優化指南 2026〉。
常見問題
結構化資料會影響排名嗎?
結構化資料的作用是讓頁面有資格取得複合式搜尋結果。Google 寫明,結構化資料的手動處置只會讓頁面失去複合式結果的資格,不影響網頁搜尋的排名。
Core Web Vitals 不達標會怎樣?
Google 建議網站達到良好的 Core Web Vitals,並說這和核心排名系統想獎勵的方向一致。但它也寫明,Google 搜尋永遠優先顯示最相關的內容,就算頁面體驗不佳;反過來,報表全綠也不保證排在最前面。
TTFB 要多快?
TTFB 不屬於 Core Web Vitals。web.dev 建議大多數網站以 0.8 秒以內為目標,並說明這只是粗略的參考,因為它的重要性取決於網站怎麼產生頁面。
該不該封鎖 AI 爬蟲?
先分清楚用途。搜尋用的爬蟲(例如 OAI-SearchBot、PerplexityBot、Claude-SearchBot)擋了,可能就不會出現在那個平台的搜尋結果;訓練用的爬蟲(例如 GPTBot、ClaudeBot、Google-Extended)可以另外決定,兩者在 robots.txt 分開設定。
robots.txt 可以讓頁面不被 Google 收錄嗎?
不行。Google 寫明 robots.txt 不是讓網頁不出現在 Google 的方法,被擋的網址如果有其他網站連過來,仍可能被收錄。要讓頁面不被收錄,請用 noindex 或密碼保護。